「ChatGPTは危険だと聞くが、具体的に何がどう危ないのか」——社内で生成AIの扱いを決める立場の方から、こうした問いをよく受けます。入力した内容が学習に使われるのか、顧客の名前を入れてよいのか、無料版と法人プランで何が違うのか。調べても「情報漏洩に注意」「著作権に注意」と書かれているばかりで、では何をどう設定すればよいのかが分からない、というのが実情です。
結論から言うと、業務でChatGPTを使うときの危険性は6つに分解できます。入力情報の学習利用と外部保存、誤情報(ハルシネーション)、著作権と生成物の権利、個人情報保護法上の取扱い、アカウント共有とログ管理、そしてシャドーITです。このうち学習利用とアカウント管理は設定とプランの選択で挙動が変わり、誤情報と著作権は仕組み上なくならないため人の確認で受け止めます。危険性は「ある・ない」ではなく、どの設定で何を入力し誰のアカウントで使うかによって決まります。
そして、最も危ないのは禁止した結果として会社が把握できない利用が残ることです。全面禁止の通達は出せますが、現場のスマートフォンからの利用までは止まりません。把握できない利用は、設定も入力ルールもログも存在しない状態です。この記事は「危険だから使うな」ではなく、「どこが危ないか、どう設定すれば使えるか」を書きます。
本記事では、危険性6つの分解と効く打ち手、入力した情報の学習利用とオプトアウトの設定・保存期間・個人プランと法人プランの違い、誤情報と著作権・生成物の権利、個人情報保護法から見た論点、シャドーITとアカウント共有を踏まえた社内利用ルールの作り方、開発を外部に委託するときの取り決め、よくある質問の順に解説します。OpenAIの公式ヘルプとポリシー、個人情報保護委員会・文化庁・経済産業省の公表資料を直接確認し、確認日(2026年9月15日時点)を添えました。仕様とプランは頻繁に変わるため、稟議に使う前に必ず最新の公式ページをご確認ください。なお本記事は法令の一般的な整理であり、法的助言ではありません。個別の判断は自社の法務部門や顧問弁護士とあわせて行ってください。
私は人材業界の出身で、2018年からホーチミンでベトナムオフショア開発の体制づくりに携わり、約100社の相談に乗ってきました。当社自身も開発にAIを活用しているため、入力してよい情報と生成コードのレビューを社内ルールで固定しています。生成AIの相談で共通するのは、「禁止しているのに現場は使っている」「委託先が使っているかどうか把握していない」の2つです。この記事を読み終えるころには、自社で何を決めればよいかが具体的な項目として見えているはずです。
目次
- ChatGPTの危険性を6つに分解する
- 危険性6分解の一覧表(何が起きるか・原因・効く打ち手)
- 「危険かどうか」ではなく「どの設定で、何を入れるか」で決まる
- 私が相談を受けて共通すると感じる2つ
- 入力した情報は学習に使われるのか
- 個人向けサービスの既定と、学習を止める設定の場所
- 保存期間と削除
- 個人プランと法人プランの比較表(既定の学習利用・管理機能・ログ・データレジデンシー)
- どちらを選ぶかの判断
- 誤情報(ハルシネーション)と、著作権・生成物の権利
- 誤情報は仕組み上なくならない
- 出力の権利は誰のものか
- 著作権侵害はどこで起きるか
- 個人情報保護法から見た論点
- 個人情報保護委員会の注意喚起(令和5年6月2日)が求めている2つの確認
- 第三者提供に当たるのか
- 実務でどうするか
- シャドーIT・アカウント共有・ログ管理を踏まえた社内利用ルールの作り方
- アカウント共有は利用規約違反
- 入力してよい情報と、入れない情報の線引き(3層で分ける)
- 社内利用ルール8項目のひな形(表)
- 最初の30日でやること
- 開発を外部に委託するときの生成AIの利用ルール
- 委託契約で決める4点(利用の可否・入力禁止情報・生成物の権利・レビュー)
- 当社のAI活用開発体制
- 【FAQ】ChatGPTの危険性に関するよくある質問
- Q1. 学習をオフにすれば安全ですか?
- Q2. 無料版と有料版で危険性は変わりますか?
- Q3. 顧客の氏名を入力してもよいですか?
- Q4. 生成した文章をそのまま公開してもよいですか?
- Q5. 社内では禁止と許可のどちらがよいですか?
- まとめ: 危険性は6つに分解できる
ChatGPTの危険性を6つに分解する——業務で実際に起きるのはどれか
「ChatGPTは危険」という言葉は、多くの場合いくつもの別々の問題をひとまとめにしています。入力した情報が学習に使われることと、出力された文章に嘘が混じっていることと、社員が個人アカウントで使っていることは、原因も対策もまったく違います。まとめて「情報漏洩リスク」と呼んでいるかぎり、打ち手は決まりません。まずは6つに分け、それぞれに何が効くのかを対応させます。なお、ツールそのものの比較検討は「AIアプリ おすすめ」の記事に譲り、ここではChatGPTを業務で使う前提で話を進めます。
危険性6分解の一覧表(何が起きるか・原因・効く打ち手)
No | 危険性 | 業務で何が起きるか | 原因 | 効く打ち手 |
|---|---|---|---|---|
1 | 入力情報の学習利用と外部保存 | 社外秘の資料や顧客リストを貼り付けた内容が、モデルの学習に使われたり、事業者のサーバに保存されたりする | 個人向けサービスは既定で会話が学習に使われうる。会話は削除するまで保存される | プランの選択と設定(学習の停止)、入力してよい情報の線引き |
2 | 誤情報(ハルシネーション) | もっともらしい嘘の数字・条文・出典が混じった文章を、確認せずに社外へ出してしまう | 確率的に次の語を選ぶ仕組みで、正確性が保証されていない | 人による確認を業務フローに組み込む。一次情報での裏取りを必須にする |
3 | 著作権と生成物の権利 | 生成した文章や画像が既存の著作物に似ており、公開後に指摘を受ける。あるいは生成物を自社のものとして扱えるか判断がつかない | 出力は学習データに由来し、類似したものが生成されうる。他の利用者が似た出力を受け取ることもある | 公開前の類似性チェック、用途の限定、契約での権利の整理 |
4 | 個人情報保護法上の取扱い | 顧客の氏名・連絡先を含むプロンプトを入力し、利用目的の範囲外の取扱いになる | 個人データの取扱いに関する確認をせずに入力している | 利用目的の確認、機械学習に利用されない設定・プランの確認、安全管理措置 |
5 | アカウント共有とログ管理 | 部署で1つのアカウントを使い回し、誰が何を入力したか追えない。退職者のアカウントが残る | 個人契約の延長で業務利用が始まり、管理台帳がない | 会社ドメインでの登録、共有の禁止、管理コンソールとログの確認、棚卸し |
6 | シャドーIT | 会社が禁止しているのに、私物端末や個人アカウントで使われている。設定も入力ルールも及ばない | 全面禁止は利用の動機を消さない。便利さが残るかぎり地下に潜る | 利用の可視化、公式の利用手段の提供、相談窓口の設置 |
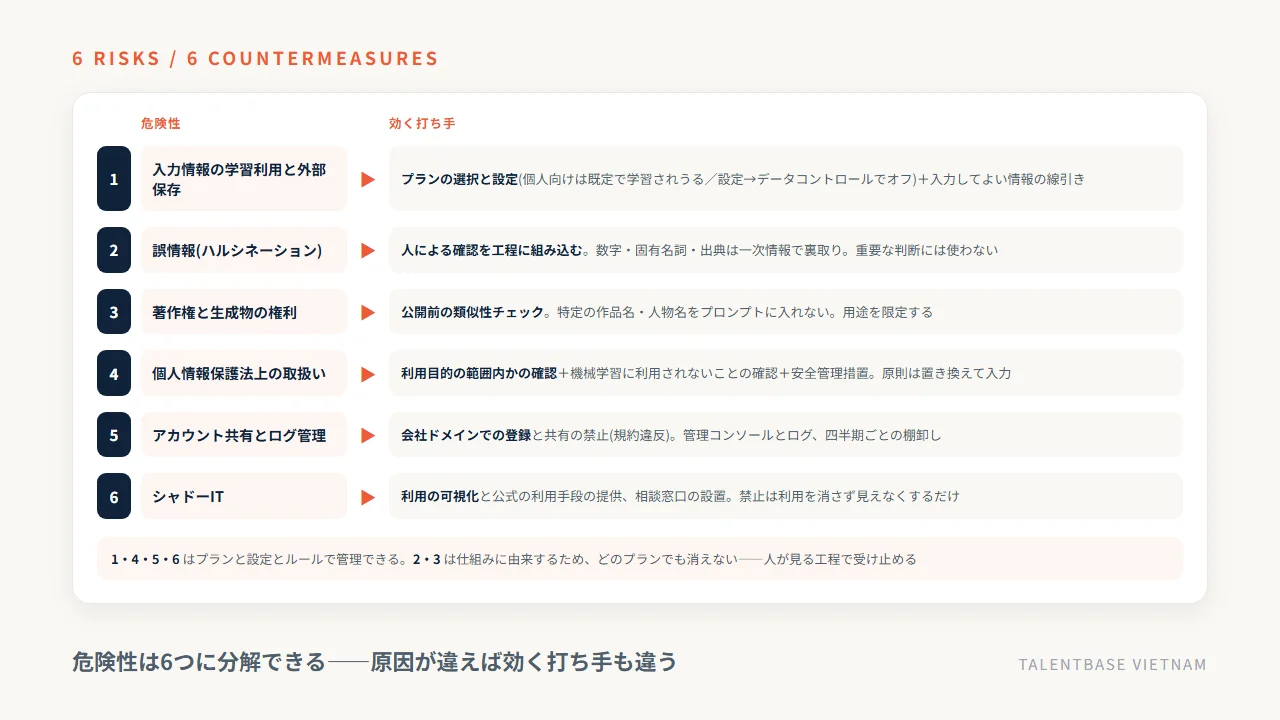
この表で分かるとおり、6つのうち1・4・5・6はプランの選択、設定、ルールの整備で管理できます。一方、2と3は仕組みに由来するため、どのプランを選んでもゼロにはなりません。ここを混同したまま「法人プランにすれば安全」と説明すると、誤情報をそのまま社外に出す事故が残ります。
「危険かどうか」ではなく「どの設定で、何を入れるか」で決まる
生成AIのリスクを議論するとき、「ChatGPTは安全か」という問いの立て方そのものが答えを出しにくくしています。同じChatGPTでも、個人が無料版に社外秘のExcelを貼るのと、会社が契約した法人プランで一般公開されている情報を要約するのとでは、リスクの大きさが何桁も違います。決めるべき変数は3つです。どのプランを使うか、何を入力してよいか、誰のアカウントで使うか。この3つが決まれば、残るリスクは誤情報と権利の2つに絞られます。
逆に言えば、この3つが決まっていない状態が最も危険です。プランが決まっていなければ学習利用の扱いが分かりません。入力の線引きがなければ社員は判断のしようがありません。アカウントが管理下になければ、何が起きたかを後から追えません。危険性の大半は、技術の問題ではなく決めていないことの問題です。
私が相談を受けて共通すると感じる2つ——禁止しているのに使われている、委託先の利用を把握していない
私は2018年からホーチミンで約100社の開発体制の相談に乗ってきましたが、生成AIの話題になると、共通して出てくる状況が2つあります。1つ目は「全面禁止の通達は出したが、現場は個人のスマートフォンで使っている」というものです。禁止した瞬間から利用が見えなくなるため、何を入力しているかを会社は知りません。設定も入力ルールもログも、届かないところで使われています。禁止は、危険を消すのではなく見えなくするだけ、というのが実情です。
2つ目は「開発を外部に委託しているが、委託先が生成AIを使っているかどうか把握していない」というものです。契約書には秘密保持条項があるだけで、生成AIへの入力については何も書かれていない。委託先のエンジニアが自社のソースコードや仕様書を生成AIに貼っているかどうか、確かめる術がありません。これは開発の発注側に共通する盲点で、後半の章で取り決め方を整理します。次章では、6つのうち読者が最も知りたい1つ目——入力した情報が実際にどう扱われるのかを、OpenAIの公式情報で確認します。
入力した情報は学習に使われるのか——オプトアウトの設定と保存期間、法人プランとの違い【2026年9月15日時点】
ここが読者の最大の関心で、同時に最も誤解が多いところです。以下はOpenAIの公式ヘルプ「How your data is used to improve model performance」「Data Controls FAQ」、エンタープライズプライバシーのページ(2026年1月8日更新)、および利用規約(2026年1月1日発効)を2026年9月15日に直接確認した内容です。生成AIの仕様とプラン構成は頻繁に変わるため、社内資料に転記する際は必ず最新の公式ページで確かめてください。プランごとに扱いが違うので、混同しないことが何より大切です。
個人向けサービスの既定と、学習を止める設定の場所
OpenAIは自社サービスを「個人向け(services for individuals)」と「法人向け(services for businesses)」に分けて説明しています。2026年9月時点の料金ページでは、個人向けが無料版・Go・Plus・Proの4つ、法人向けがBusinessとEnterpriseの2つ(法人向けは2名から)という構成です。かつての「Team」に相当する位置づけは、現在はChatGPT Businessとして整理されています。
個人向けのChatGPTについて、OpenAIは「お客様のコンテンツをモデルの学習に使用する場合があります」と明記しています。つまり、無料版でもPlusでもProでも、既定では会話が学習に使われうるということです。有料だから学習されない、という理解は誤りです。
学習を止めるには、ChatGPTの設定→データコントロール(Data Controls)で「Improve the model for everyone」をオフにします。ウェブ版ではプロフィールアイコン→設定→データコントロールの順、モバイルではサイドバー→プロフィールアイコン→データコントロールの順です。OpenAIのプライバシーポータルで「Do not train on my content」を選択する方法もあり、どちらか一方で足ります。設定はアカウント単位で反映されるため、ウェブとモバイルの両方で操作する必要はありません。オフにした後は、新しい会話がモデルの学習に使われなくなります。
ただし、オフにしても消えないものが2つあります。1つは会話履歴です。学習に使われなくなるだけで、履歴はアカウントに残り続けます。もう1つは、利用者が明示的にフィードバックを送った場合の例外です。OpenAIは、学習をオフにしていても回答への高評価・低評価などのフィードバックを送信した場合、そのフィードバックに紐づく会話全体が学習に使われる可能性があると説明しています。社内ルールを作るなら、「フィードバックボタンは押さない」の一行を入れておくと確実です。
保存期間と削除——一時チャット、削除した会話、フィードバックの例外
保存の話は学習の話とは別物です。学習に使われないことと、保存されないことは同じではありません。
一時チャット(Temporary Chat)は、履歴に残らず、メモリを作成・使用せず、モデルの学習にも使われません。OpenAIは一時チャットを30日後にシステムから削除すると説明しており、不正利用の監視のためにのみ確認されることがあるとしています。一度きりの下書きや、社外に出さない検討メモには向いた使い方です。
通常の会話を削除した場合は、画面上からはすぐに消え、原則として30日以内にOpenAIのシステムから完全に削除されます。ただし、すでに匿名化されアカウントとの紐付けが解除されている場合や、セキュリティ上・法令上の保持義務がある場合は例外とされています。削除した会話はUI・API・サポートのいずれからも復元できません。アーカイブは削除ではなく、アカウント内に残ったままになる点にも注意が必要です。
個人プランと法人プランの比較表(既定の学習利用・管理機能・ログ・データレジデンシー)
法人向けのChatGPT BusinessとEnterpriseでは、既定の扱いが逆になります。OpenAIは「ビジネス向けの製品(ChatGPT Business、ChatGPT Enterprise、API)からの入力・出力について、既定ではモデルの学習に使用しない」と明記しています。組織が明示的にオプトインした場合を除き、既定でデータ共有はオフです。会社として使うなら、設定に依存せず既定で学習されない側を選ぶ、という判断がまず立ちます。
比較軸 | 個人向け(無料版・Go・Plus・Pro) | 法人向け(Business・Enterprise) |
|---|---|---|
既定の学習利用 | 使われうる。設定でオフにできる | 既定で使われない(明示的にオプトインした場合を除く) |
停止の方法 | 利用者本人が設定→データコントロールで操作 | 設定不要(既定)。組織として管理 |
会話の保持期間 | 削除するまで保持。削除後は原則30日以内に消去 | ワークスペース管理者が保持期間を設定できる。削除後は原則30日以内に消去 |
管理者による把握 | できない(個人のアカウント) | 管理コンソールでメンバーとワークスペースを管理。Businessは管理者が会話履歴の閲覧・エクスポート・削除が可能 |
監査ログ | なし | Enterpriseは Compliance API 経由で会話とGPTの監査ログにアクセスできる |
認証・アクセス管理 | 個人のログイン | SAML SSO、SCIM、ロールベースのアクセス制御、IP許可リスト(プランにより差異) |
第三者認証 | — | SOC 2 Type 2 監査を完了。EnterpriseはISO 27001・27017・27018・27701 |
データの保存地域 | 指定できない | 米国・EU・英国・日本・カナダなどのデータレジデンシーに対応 |
DPA(データ処理補遺) | — | ChatGPT Business・Enterprise・APIで締結可能 |
暗号化 | 保存時 AES-256 / 通信時 TLS 1.2以上 | 同左 |
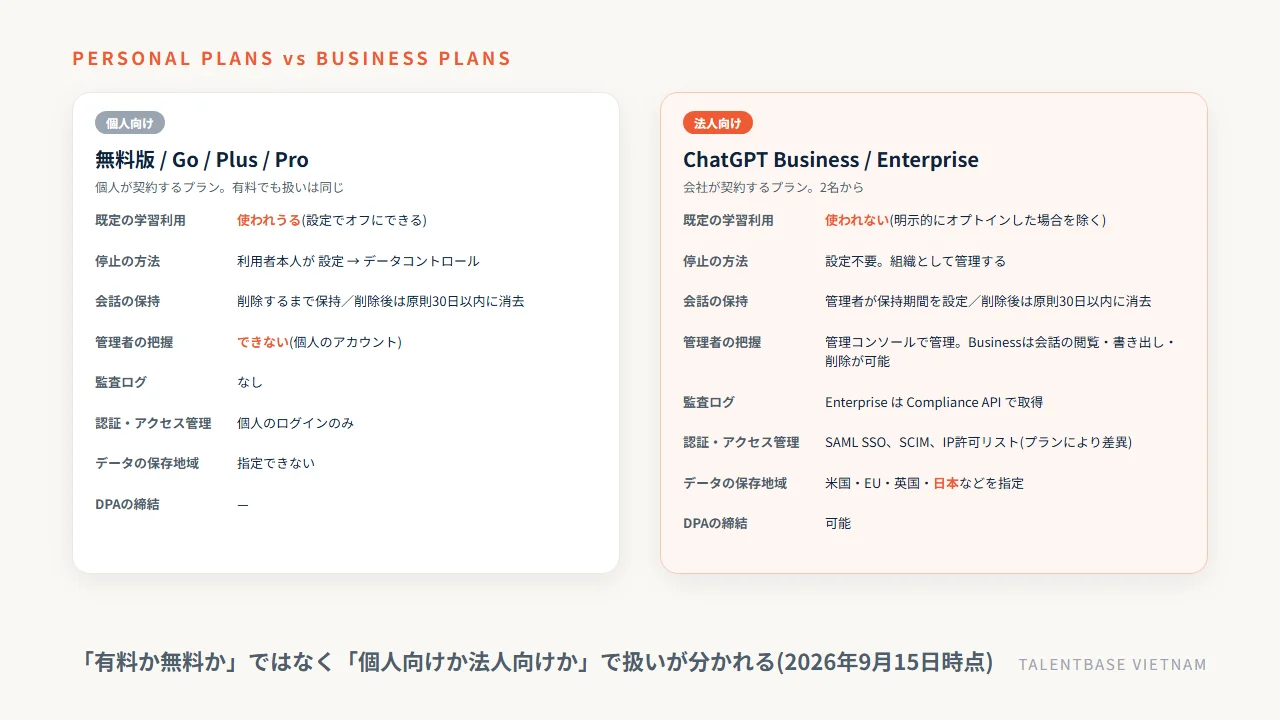
法人プランで押さえておきたいのは、「既定で学習されない」ことと「保存されない」ことは別だという点です。会話はワークスペースに保存され、Businessでは管理者が閲覧・エクスポート・削除できます。従業員から見れば、業務用アカウントの会話は会社が見られる前提です。この点は社内に周知しておかないと、後で軋轢のもとになります。
どちらを選ぶかの判断——個人プランの設定変更で足りる場合と、法人プランが要る場合
全員に法人プランを配るのが最短ですが、費用が理由で踏み切れない会社も多いはずです。判断の分かれ目は3つあります。第1に、業務で扱う情報に顧客の個人データや契約上の秘密情報が含まれるか。含まれるなら法人プランを前提にしてください。第2に、誰が何を入力したかを後から追う必要があるか。監査や事故対応が求められる業種では、ログの有無が決定的です。第3に、利用者が10名を超えるか。設定の徹底を個人任せにできる人数には限界があります。
逆に、一般公開されている情報の要約や文章の推敲に用途を限り、利用者が数名にとどまるなら、個人プランで学習をオフにし、入力禁止情報を明文化する運用でも成立します。その場合は、設定がオフになっていることを定期的に確認する担当を決めてください。設定は利用者本人しか変えられないため、会社側からは見えません。ここを放置したままの「設定したつもり」は失敗のもとです。
誤情報(ハルシネーション)と、著作権・生成物の権利——出力をそのまま使えない2つの理由
前章の6分解のうち、2つ目と3つ目はプランを変えても設定を変えても残ります。誤情報と権利は、生成の仕組みそのものに由来するからです。この2つに対する打ち手は1つしかありません。出力を最終成果物として扱わず、人が確認する工程を業務フローに組み込むことです。当たり前に聞こえますが、確認を「気をつける」という気持ちの問題にしている会社が多く、ここが事故の入口になります。
誤情報は仕組み上なくならない——利用規約が自ら認めている3点
OpenAIの利用規約(2026年1月1日発効)は、精度について次の3点を明記しています。第1に、アウトプットは常に正確であるとは限らず、真実または事実に基づく情報の唯一の情報源として、また専門家のアドバイスの代わりとして依拠すべきではないこと。第2に、利用または共有する前に、必要に応じて人による確認を行うなど、利用者が正確性と適切性を評価する必要があること。第3に、信用・教育・雇用・住宅・保険・法律・医療その他の重要な決定など、個人に法的または重大な影響を与える可能性のある目的で、その個人に関するアウトプットを使用してはならないこと。
3つ目は特に重要です。採用の合否判定、与信、人事評価のように、個人に不利益が及びうる判断に生成AIの出力を使うことは、規約上そもそも許されていません。「参考にする」という言い方で実質的に判断材料にしている運用も、線引きを社内で決めておかないと後から説明がつかなくなります。
誤情報が業務で表面化しやすいのは、法令の条文番号、統計の数値、他社の料金、固有名詞の役職といった「調べれば分かるが調べるのが面倒な情報」です。生成AIはこれらをもっともらしい形で出力します。社外に出る文書では、数字と固有名詞と出典の3つを一次情報で裏取りする、というルールにしておくと現実的に回ります。
出力の権利は誰のものか——所有と、他のユーザーが似た出力を受け取る可能性
権利の話は2つに分かれます。OpenAIとの関係で誰が権利を持つかと、第三者の著作権を侵害しないかです。
前者について、利用規約は「お客様はインプットに対する所有権を保持し、アウトプットを所有します」とし、OpenAIがアウトプットに関して有する権利があればすべて利用者に譲渡すると定めています(適用法令が認める範囲において)。つまり、OpenAIから「生成物は当社のものだ」と言われる心配は、規約上はありません。
ただし、同じ規約には「アウトプットは特有のものではない場合があり、他のユーザーが当社のサービスから同様のアウトプットを受け取る場合があります」という一文が続きます。そして、上記の権利譲渡は他のユーザーのアウトプットには適用されません。ロゴやキャッチコピーのように独占的に使いたいものを生成AIだけで作るのは、この点で向きません。ソースコードや成果物の権利の整理そのものは「システム開発 著作権」の記事で扱っているため、ここでは深入りしません。
著作権侵害はどこで起きるか——文化庁の考え方(令和6年3月)と、業務での確認手順
第三者の著作権を侵害するかどうかは、日本では著作権法の一般的な枠組みで判断されます。文化庁は、文化審議会著作権分科会法制度小委員会が令和6年3月15日に取りまとめた「AIと著作権に関する考え方について」を公表しており、令和6年7月31日には「AIと著作権に関するチェックリスト&ガイダンス」を公開しています。生成AIと著作権に関する判例の蓄積がない現状を踏まえ、現行法の解釈を整理したものです。
実務で押さえるべきは、生成・利用の段階での侵害は、既存の著作物との類似性と、それに依拠したかどうかで判断されるという枠組みです。特定の作品名やキャラクター名をプロンプトに入れて似たものを生成させる使い方は、この観点でリスクが高くなります。逆に、一般的な指示で書かせた事務的な文章が既存の著作物に似る可能性は低いといえます。
業務では、次の3段階で確認するのが現実的です。第1に、プロンプトに特定の作品・人物・ブランドの名前を入れない。第2に、公開する文章は主要な一文を検索して既存記事との一致を確認する。第3に、画像やロゴなど視覚的な生成物は公開前に社内の別の担当者が確認する。当社が開発で守っている品質の考え方も同じで、日本人PMによる設計レビュー、Gitのプルリクエストによるコードレビューの標準化、リリース前のダブルチェックという3段階を置いています。生成AIを使うかどうかにかかわらず、人が見る工程を仕組みとして固定しておくことが、誤情報と権利の両方に効く唯一の打ち手です。
個人情報保護法から見た論点——プロンプトに個人データを入れる前に確認する3点
「顧客の氏名を入れてよいか」は、社内で最も判断が割れる質問です。ここでは個人情報保護委員会の公表資料をもとに、確認すべき3点を整理します。以下は法令の一般的な整理であり、法的助言ではありません。個別の事案の判断は、自社の法務部門や顧問弁護士とあわせて行ってください。
個人情報保護委員会の注意喚起(令和5年6月2日)が求めている2つの確認
個人情報保護委員会は令和5年6月2日、「生成AIサービスの利用に関する注意喚起等について」を公表しました。個人情報取扱事業者に向けた注意点として、次の2つが挙げられています。
第1に、生成AIサービスに個人情報を含むプロンプトを入力する場合には、特定された当該個人情報の利用目的を達成するために必要な範囲内であることを十分に確認すること。つまり、自社が公表している利用目的の範囲を超えて個人情報を使うことにならないか、という確認です。「問い合わせ対応のために取得した顧客情報」を、生成AIに入れて要約させる行為が利用目的の範囲内かどうかは、自社の利用目的の書きぶり次第で変わります。
第2に、あらかじめ本人の同意を得ることなく生成AIサービスに個人データを含むプロンプトを入力し、当該個人データがプロンプトに対する応答結果の出力以外の目的で取り扱われる場合、個人情報保護法の規定に違反することとなる可能性があること。そのため、このようなプロンプトの入力を行う場合には、生成AIサービスを提供する事業者が当該個人データを機械学習に利用しないこと等を十分に確認すること、とされています。
この2点目が、前章で見た「学習に使われるかどうか」の確認が法令上も意味を持つ理由です。応答を返すためだけに使われるのか、学習にも使われるのかで、扱いが変わりうるという整理になっています。
第三者提供に当たるのか——Q&A Q7-53の考え方と、外国のサーバ(Q12-3)
「生成AIに個人データを入力する行為は第三者提供(法第27条第1項)に当たるのか」という問いには、個人情報保護委員会のガイドラインQ&Aが参考になります。
Q7-53は、クラウドサービスの利用が第三者提供または委託に該当するかどうかは、保存している電子データに個人データが含まれているかどうかではなく、クラウドサービスを提供する事業者において個人データを取り扱うこととなっているのかどうかが判断の基準になる、としています。そして、当該事業者が個人データを取り扱わないこととなっている場合には、個人データを提供したことにならないため本人の同意は不要であり、委託にも該当しないと整理しています。「取り扱わないこととなっている場合」とは、契約条項によってその旨が定められており、適切にアクセス制御を行っている場合等が考えられる、とされています。
Q12-3は外国にあるサーバについてのもので、外国にある事業者が管理・運営するサーバに個人データを保存する場合であっても、その事業者が保存された個人データを取り扱わないこととなっている場合には、外国にある第三者への提供(法第28条第1項)に該当しない、としています。ただし、外国において個人データを取り扱うことになるため、当該外国の制度を把握したうえで安全管理のために必要かつ適切な措置を講ずる必要がある(法第23条)ことも明記されています。
これらはクラウドサービス一般についてのQ&Aであり、生成AIサービスにそのまま当てはめてよいかは、契約条項と実際の取扱いの内容を個別に確認する必要があります。法人向けプランでデータ処理補遺(DPA)を締結し、学習に利用されない条件を契約で押さえるという手順が、この確認に対応する実務上の一手です。なお、開発の委託先が国外にある場合のデータの取扱いは論点が別で、当社の拠点であるベトナムを例にした整理は「ベトナム データ越境 個人情報」の記事にまとめています。
実務でどうするか——法解釈を突き詰めるより「入れない運用」を設計する
正直に言えば、生成AIへの個人データ入力の位置づけを社内で完全に詰めきるのは容易ではありません。契約条項と実際の取扱いを突き合わせる作業が要り、サービス側の仕様変更で前提が動くこともあります。
実務でより早いのは、そもそも個人データを入力しない運用を設計することです。顧客の氏名・住所・電話番号・メールアドレス・顧客IDは、プロンプトに入れる前に「A様」「担当者X」のような置き換えで処理する。取引先名は業種と規模だけを書く。この置き換えを社内ルールに明記し、テンプレートを配ってしまうほうが、法解釈の詰めを待つより現場が動きます。
そのうえで、どうしても個人データを扱う業務(問い合わせ履歴の分析など)については、法人プランとDPAを前提に、利用目的の記載を見直し、安全管理措置の内容を整理するという順で進めてください。繰り返しになりますが、本記事は一般的な整理であり、最終的な適法性の判断は個別の事情によります。自社の法務部門や顧問弁護士とご確認ください。
シャドーIT・アカウント共有・ログ管理を踏まえた社内利用ルールの作り方——8項目のひな形と最初の30日
ここまでの5つの危険性は、最後の1つ——シャドーIT——を解消しないかぎり、対策として機能しません。設定もプランもルールも、会社が把握している利用にしか届かないからです。この章では、把握できる状態を作るところから順に、社内ルールの形に落とします。経済産業省と総務省の「AI事業者ガイドライン」は2026年3月31日に第1.2版が公開されており、社内規程の根拠として参照する会社が増えています。ここでは実務で先に決めるべき項目に絞って整理します。
アカウント共有は利用規約違反——会社ドメインでの登録と、退職時の棚卸し
まず押さえておくべき事実として、OpenAIの利用規約は「アカウントの認証情報を他人と共有したり、アカウントを他人に利用可能にしたりしてはなりません」と定めています。部署で1つのアカウントを買って回す運用は、費用の節約に見えて規約違反であり、かつ誰が何を入力したかを追えなくします。事故が起きたときに範囲を特定できないことが、この運用の本当の危うさです。
次に、登録に使うメールアドレスを会社ドメインに統一してください。利用規約には、組織が所有するメールアドレスでアカウントを作成した場合、そのアカウントが組織のビジネスアカウントに追加される場合があるという記載があり、移行後は組織の管理者がアカウントを管理できるようになるとされています。逆に、個人のGmailで登録されたアカウントは、退職後も本人の手元に残ります。社員が個人メールで登録し、業務の資料を入れたまま退職する。この形が最も後始末が難しく、要注意です。
そのうえで、四半期に一度の棚卸しを決めておきます。確認するのは3つです。利用者の一覧と実際の在籍者が一致しているか、退職者のアカウントが無効化されているか、個人プランを使っている利用者の学習設定がオフのままか。3つ目は本人にしか確認できないため、自己申告の形で記録に残す運用にしてください。
入力してよい情報と、入れない情報の線引き(3層で分ける)
「機密情報を入力しない」というルールは、現場では機能しません。何が機密かの判断を各人に投げているからです。3層に分けて具体名で示してください。
層 | 分類 | 具体例 | 扱い |
|---|---|---|---|
1 | 入力してよい | 一般公開済みの自社情報、公開資料の要約、一般的な文章の推敲、公開されている技術情報 | 制限なし。ただし出力の確認は必須 |
2 | 条件つきで入力してよい | 社内向けの文書、個人名を伏せた業務データ、仮名化した数値 | 法人プランに限る。個人名・取引先名・固有のIDは置き換えてから入力する |
3 | 入力しない | 顧客の氏名・住所・連絡先・顧客ID、未公開の財務数値、人事評価と健康情報、ソースコードと認証情報、秘密保持契約の対象資料 | 例外なし。必要な場合は別途申請し、法務の確認を経る |
第3層に「ソースコードと認証情報」を入れているのは、APIキーやパスワードが紛れ込みやすいためです。設定ファイルやログをそのまま貼り付けると、認証情報ごと外部に出ます。開発現場では、この一点だけでも周知の効果があります。
社内利用ルール8項目のひな形(表)
No | 項目 | 決める内容の例 |
|---|---|---|
1 | 対象と範囲 | 対象サービス(ChatGPTほか)、対象者(全社員・業務委託を含むか)、対象業務 |
2 | 使用するアカウント | 会社ドメインのアカウントのみ。個人アカウントでの業務利用と共有を禁止 |
3 | 使用するプラン | 法人プランを標準とする。個人プランを認める場合は学習設定のオフを条件とする |
4 | 入力してよい情報 | 上記の3層を添付。判断に迷う場合は入力しない、を原則とする |
5 | 出力の取り扱い | 数字・固有名詞・出典は一次情報で裏取りする。個人に重大な影響を与える判断には使わない |
6 | 権利の確認 | 公開物は類似性を確認する。特定の作品名・人物名をプロンプトに入れない |
7 | 記録と監査 | 業務での利用範囲、管理者によるログ確認の有無と頻度を明示する |
8 | 相談窓口と例外申請 | 判断に迷ったときの相談先、第3層の情報を扱う場合の申請手順と決裁者 |
このひな形で大事なのは、8項目目の相談窓口です。禁止事項だけを並べたルールは、判断に迷った社員を黙らせるだけで、結果的にこっそり使わせます。「迷ったら聞ける先」があることが、シャドーITを減らす最も効く仕組みです。
最初の30日でやること——可視化、プラン決定、ルール配布、相談窓口
順序を間違えないでください。最初にやるのはルールの起案ではなく、利用実態の可視化です。1週目は、各部署に「誰が何に使っているか」を無記名で申告してもらいます。責任追及をしないと明言することが条件です。2週目は、その用途をもとに扱う情報の層を判定し、法人プランが要るかどうかを決めます。3週目に8項目のルールと3層の線引きを文書化し、4週目に配布と説明を行い、同時に相談窓口を立てます。
30日で完璧なルールは作れませんが、「会社が把握していて、相談先がある」状態までは作れます。禁止に戻すのはいつでもできますが、一度地下に潜った利用を表に出すのは難しい、というのが実情です。
開発を外部に委託するときの生成AIの利用ルール——当社のAI活用開発体制と取り決め方
自社の社内ルールが固まっても、開発を外部に委託していれば、もう一つ決める先が残ります。委託先のエンジニアが生成AIを使うかどうかです。前半で触れたとおり、これは発注側に共通する盲点で、契約書に秘密保持条項があるだけでは生成AIへの入力は止まりません。委託先のセキュリティ対策全般は「オフショア開発 セキュリティ対策」の記事に整理していますので、ここでは生成AIに絞った取り決めだけを扱います。
委託契約で決める4点(利用の可否・入力禁止情報・生成物の権利・レビュー)
No | 決める項目 | 書く内容の例 |
|---|---|---|
1 | 利用の可否 | 開発業務で生成AIを使ってよいか。使う場合は対象サービスとプラン(既定で学習に使われない法人プランに限る等)を特定する |
2 | 入力禁止情報 | 発注者から受領した仕様書・設計書・ソースコード・本番データ・認証情報の入力可否を明記する。可とする場合は範囲を限定する |
3 | 生成物の権利と表示 | 生成AIを用いて作成した成果物の権利の帰属、第三者の権利を侵害しないことの表明、生成AIの使用箇所の報告義務の有無 |
4 | レビューと記録 | 生成されたコードのレビュー手順(コードレビューの必須化)、脆弱性の確認、利用の記録と報告の頻度 |
現実的なのは、全面禁止ではなく2番目の入力禁止情報で線を引き、4番目のレビューで品質と脆弱性を受け止める組み方です。生成AIの利用を禁止しても、委託先の手元で使われているかどうかを発注側が確かめる手段はありません。「使う前提で条件を決める」ほうが実効性があります。AIを使った開発そのものを外注する場合の確認項目は「AI駆動開発 外注」と「AI開発 外注」の記事に、生成AIアプリを自社で作る場合の技術論点は「生成AIアプリ開発」の記事に分けてまとめています。
当社のAI活用開発体制——使う前提で、入力とレビューを固定する
当社はAI活用開発体制を取っており、開発の生産性向上に生成AIを用いています。そのうえで、お客様から受領した情報の入力範囲と、生成されたコードのレビューを固定しています。品質の担保は3点で、日本人PMによる設計レビュー、Gitのプルリクエストによるコードレビューの標準化、リリース前のダブルチェックです。生成AIを使うかどうかにかかわらず、人が見る工程が抜けない形にしてあります。
体制は、日本人PM・ブリッジSEとエンジニアを組み合わせるパターンAと、エンジニアのみのパターンBの2つです。1名から、最短2週間で開始でき、増員は約1週間、縮小と交代は1か月単位で調整します。契約と支払いは日本国内法人・日本法準拠で、海外送金は不要です。エンジニアはグループが持つ2,000名以上のIT人財データベースから直接アサインするため、協力会社経由の仲介マージンが発生しません。公開単価は実務3年目安で1,500USD(約22.5万円)、5年で2,000USD、10年・ブリッジSEで3,000USDです(1USD=150円換算の目安)。実績としては、介護記録SaaSのCareViewer、LLMを組み込んだ24時間対応のAIチャットボットなどがあります。
向く案件と向かない案件も正直にお伝えします。生成AIの利用ルールを含めて運用を一緒に設計したい継続開発には向きます。逆に、生成AIの利用を一切認めない前提で要件が確定した単発開発であれば、当社の体制の利点は出にくくなります。委託先を選ぶとき、「生成AIを使っていますか」と聞いて、使っていないと答える会社と、使ったうえで入力範囲とレビューを説明できる会社。どちらが自社の情報を安全に扱うでしょうか。
【FAQ】ChatGPTの危険性に関するよくある質問
ChatGPTの危険性について、社内の説明会で繰り返し出る質問を5つにまとめました。回答は2026年9月15日時点の公式情報に基づくもので、法的助言ではありません。社内資料に転記する際は最新の公式ページをご確認ください。
Q1. 学習をオフにすれば安全ですか?
学習に使われなくなるだけで、会話そのものは保存されます。オフにしても履歴はアカウントに残り、削除は別の操作です。また、回答への評価などのフィードバックを送ると、その会話全体が学習に使われる可能性があると説明されています。安全かどうかは、何を入力するかで決まります。
Q2. 無料版と有料版で危険性は変わりますか?
個人向けのプラン(無料版・Go・Plus・Pro)は、有料でも既定では会話が学習に使われうる点で同じです。扱いが変わるのは、法人向けのChatGPT BusinessとEnterpriseで、こちらは既定で学習に使われません。「有料にしたから安全」ではなく、「個人向けか法人向けか」で分かれると理解してください。
Q3. 顧客の氏名を入力してもよいですか?
個人情報保護委員会は、個人データを含むプロンプトを入力する場合、利用目的の範囲内であることと、生成AIの提供事業者が機械学習に利用しないこと等を十分に確認するよう求めています。実務としては、氏名や連絡先を「A様」のように置き換えてから入力する運用を標準にするほうが確実です。どうしても必要な業務は、法人プランとデータ処理補遺(DPA)を前提に、法務と個別に判断してください。
Q4. 生成した文章をそのまま公開してもよいですか?
利用規約上、アウトプットの所有権は利用者にありますが、他の利用者が同様の出力を受け取る場合があるとも明記されています。また、既存の著作物との類似性によっては権利侵害になりえます。公開する文章は、数字と固有名詞と出典を一次情報で裏取りし、主要な一文を検索して既存記事との一致を確認してから出してください。
Q5. 社内では禁止と許可のどちらがよいですか?
禁止は利用を消すのではなく見えなくします。私が相談を受けるなかでも、全面禁止の会社ほど現場が個人の端末で使っている状況をよく見ます。推奨は、会社ドメインのアカウントに集約し、入力してよい情報を3層で示し、相談窓口を置いたうえでの条件つき許可。
まとめ: 危険性は6つに分解できる——プランと設定で消せるものを消し、残りは人の確認とルールで受け止める
業務でChatGPTを使うときの危険性は、入力情報の学習利用と外部保存、誤情報(ハルシネーション)、著作権と生成物の権利、個人情報保護法上の取扱い、アカウント共有とログ管理、シャドーITの6つです。このうち学習利用・個人情報・アカウント管理・シャドーITの4つは、プランの選択、設定、ルールの整備で管理できます。残る誤情報と権利の2つは仕組みに由来するため消えず、人が確認する工程を業務フローに組み込むほかありません。
先に決めるべき変数は3つです。どのプランを使うか、何を入力してよいか、誰のアカウントで使うか。OpenAIの公式情報では、個人向けのサービスは既定で会話が学習に使われうる一方、設定→データコントロールの「Improve the model for everyone」をオフにすれば停止でき、法人向けのChatGPT BusinessとEnterpriseは既定で学習に使われません(2026年9月15日確認)。個人情報保護委員会は、個人データを含むプロンプトを入力する場合に利用目的の範囲内かを確認し、機械学習に利用されないこと等を十分に確認するよう求めています。入力の線引きは3層に分け、アカウントは会社ドメインに集約し、相談窓口を置く。最初の30日は、ルールの起案より先に利用実態の可視化から始めてください。
そして、開発を外部に委託しているなら、委託先との取り決めがもう一段残ります。秘密保持条項だけでは生成AIへの入力は止まりません。利用の可否、入力禁止情報、生成物の権利、レビューの4点を書いてください。当社はAI活用開発体制を取ったうえで、受領情報の入力範囲と、日本人PMの設計レビュー・Gitプルリクエストによるコードレビュー・リリース前ダブルチェックという3段階を固定しています。委託先のセキュリティ全般はオフショア開発のセキュリティ対策、AIを使った開発そのものを外注する場合はAI開発を外注する進め方もあわせてご覧ください。現在の体制と要件をお聞かせいただければ、生成AIの利用ルールを含めた体制の組み方と概算見積もりでお答えします。合わない案件にはその旨も率直にお伝えします。なお本記事は法令の一般的な整理であり、法的助言ではありません。個別の判断は自社の法務部門や顧問弁護士とあわせて行ってください。