「デモは動いたのに、本番に出す判断ができない」——生成AIを組み込んだアプリを作ろうとしている方から、こうした相談をよく受けます。試作したチャットボットは社内で好評だった。でも、たまに事実と違うことを答える。月額がいくらになるのか読めない。この状態で全社に公開してよいのか、誰も判断できない。作ること自体は難しくなかったのに、最後の一歩で止まる。これが生成AIアプリ開発の実情です。
結論から言うと、止まる原因は技術力ではありません。設計時に決めておくべき7つの論点——モデルとAPIの選定、社内データの渡し方、プロンプトの管理、ハルシネーション対策と評価の合格基準、レイテンシの体感設計、費用の試算と上限制御、ログと個人情報の扱い——のうち、どれかを決めないまま作り始めたことが原因です。逆に、この7つを先に決めてしまえば、あとは普通のアプリ開発と同じ手順で進みます。
生成AIアプリが普通のアプリと違うのは、同じ入力でも出力が毎回変わること、使った分だけ費用が増えること、精度が渡すデータの質で決まることの3点だけです。この3点から、従来の開発にはなかった判断が生まれます。「何をもって合格とするか」「月額をいくらで止めるか」「どのデータをモデルに渡すか」。これらは技術の問題ではなく、決めごとの問題です。
本記事では、7つの論点の地図と決める順番、モデルの選定とAPI料金の読み方(各社公式ページで2026年9月15日に確認した実数と月額の試算)、RAGとベクトルDBと既存アプリへの後付け組み込み、プロンプトの管理とハルシネーション対策・評価(Evals)の作り方、レイテンシとログ・個人情報の扱い、当社の体制、よくある質問の順に解説します。API料金は変動が速いため、確認日を明記しています。
私は人材業界の出身で、2018年からホーチミンでベトナムオフショア開発の体制づくりに携わり、約100社の相談に乗ってきました。当社ではLLMを組み込んだ24時間対応のチャットボットを開発した実績があり、そこでも設計の最初に決めたのは、評価用の質問セットと1リクエストあたりのトークン上限でした。この記事を読み終えるころには、自社の生成AIアプリで何を先に決めればよいかが、一覧で分かるはずです。
目次
- 生成AIアプリ開発で最初に決める7つの技術論点
- 生成AIアプリが普通のアプリと違う3つの性質
- 設計時に決める7つの論点と、決める順番
- 作り方の3つの選択肢
- モデルの選定とAPIの費用
- 主要モデルのAPI料金(2026年9月15日 各社公式ページ確認・100万トークンあたり)
- 料金表だけでは比べられない4つの理由
- 月額の試算——1リクエストのトークン数×件数で概算する
- 上限制御——想定外の請求を止める4つの仕掛け
- 社内データを答えさせる仕組み
- RAGとは——検索して渡す。学習との使い分け
- ベクトルDBの選び方
- 精度が出ないときの切り分け順
- 既存アプリへの後付け組み込み
- プロンプトの設計とバージョン管理、ハルシネーション対策と評価(Evals)の作り方
- プロンプトはコードと同じように管理する
- ハルシネーションはゼロにできない
- 評価(Evals)の作り方
- プロンプトを変えたら必ず測り直す
- レイテンシ・ストリーミングと、ログ・個人情報の扱い
- 体感を決めるのは総時間ではなく最初の1文字
- ログに何を残すか
- 個人情報と学習利用
- 当社の生成AIアプリ開発
- 当社の体制と実績
- 向く案件・向かない案件
- 【FAQ】生成AIアプリ開発に関するよくある質問
- Q1. ランニングコストは月額いくらを見ておけばよいですか
- Q2. RAGとファインチューニングのどちらを選ぶべきですか
- Q3. 精度は何%あれば本番に出せますか
- Q4. ノーコードツールで作ったものは、後で作り直しになりますか
- Q5. 社内に生成AIに詳しい人がいなくても作れますか
- まとめ: 7つの論点を先に決め、評価データで測り、費用に上限を置く
生成AIアプリ開発で最初に決める7つの技術論点——「作れるか」ではなく「どう作るか」の地図
生成AIアプリ開発とは、大規模言語モデル(LLM)をアプリの内部から呼び出し、自社の業務やデータに合わせた機能として組み込むことです。ChatGPTのような既製のサービスをそのまま使う「AI活用」とは別物で、画面も、扱うデータも、費用の出方も自社で設計します。既製のツールで足りるかどうかの判断は「AIアプリ おすすめ」の記事で整理していますので、そちらを先に読んでいただいても構いません。ここでは、作ると決めた後に何を決めるのかを地図にします。
生成AIアプリが普通のアプリと違う3つの性質——出力が揺れる、費用が従量、精度がデータで決まる
違いは3点だけです。1つ目は、同じ入力でも出力が毎回変わること。従来のアプリは同じ操作なら同じ結果を返しますが、LLMは確率的に文章を組み立てるため、表現が揺れ、ときに事実と異なる内容を自信ありげに出します(ハルシネーション)。2つ目は、費用が使った分だけ増えること。サーバー代のような固定費ではなく、処理した文字量に比例します。3つ目は、精度が渡すデータの質で決まること。モデルを高性能なものに替えるより、渡す情報を整えるほうが効くことが多いのが実情です。
この3点から、従来の開発にはなかった判断が生まれます。「何をもって合格とするか」「月額をいくらで止めるか」「どのデータをモデルに渡し、何をログに残すか」。いずれも技術の問題ではなく決めごとの問題で、決めないまま作り始めると、動くデモはできても合否を判定できないまま止まります。
なお、AIにコードを書かせて開発速度を上げる「AI駆動開発」は、本記事の話とは別のテーマです。混同されやすいので線を引いておくと、AI駆動開発は作り方の話、本記事は作るものの話です。前者は「AI駆動開発 外注」の記事で扱っています。
設計時に決める7つの論点と、決める順番
7つの論点には依存関係があります。用途が決まらないとモデルは選べず、モデルが決まらないと費用は試算できません。次の順番で決めてください。
順 | 決める論点 | 決める内容 | 決めないと起きること |
|---|---|---|---|
1 | 用途と合格基準 | 何を自動化し、どこまで正しければ合格とするか | 永久に「もう少し精度を上げてから」で止まる |
2 | モデルとAPIの選定 | どのモデルを、どの処理に使うか | 全処理を最上位モデルで回し、費用が数倍になる |
3 | 社内データの渡し方 | RAGで検索して渡すか、プロンプトに直接書くか、学習させるか | 汎用的な回答しか返らず「使えない」と言われる |
4 | プロンプトの管理 | どこに置き、誰が変更でき、版をどう残すか | 誰かが直した瞬間に品質が落ち、原因が追えない |
5 | 評価(Evals)の方法 | 何件の質問で、どの指標で、何点を合格とするか | リリース判断が担当者の主観になる |
6 | 費用の試算と上限 | 月額いくらを想定し、どこで止めるか | 想定外の請求が出て、翌月にサービスを止める |
7 | ログと個人情報 | 何を残し、何をマスクし、学習利用をどう切るか | 個人情報がログに残り、後から消せない |
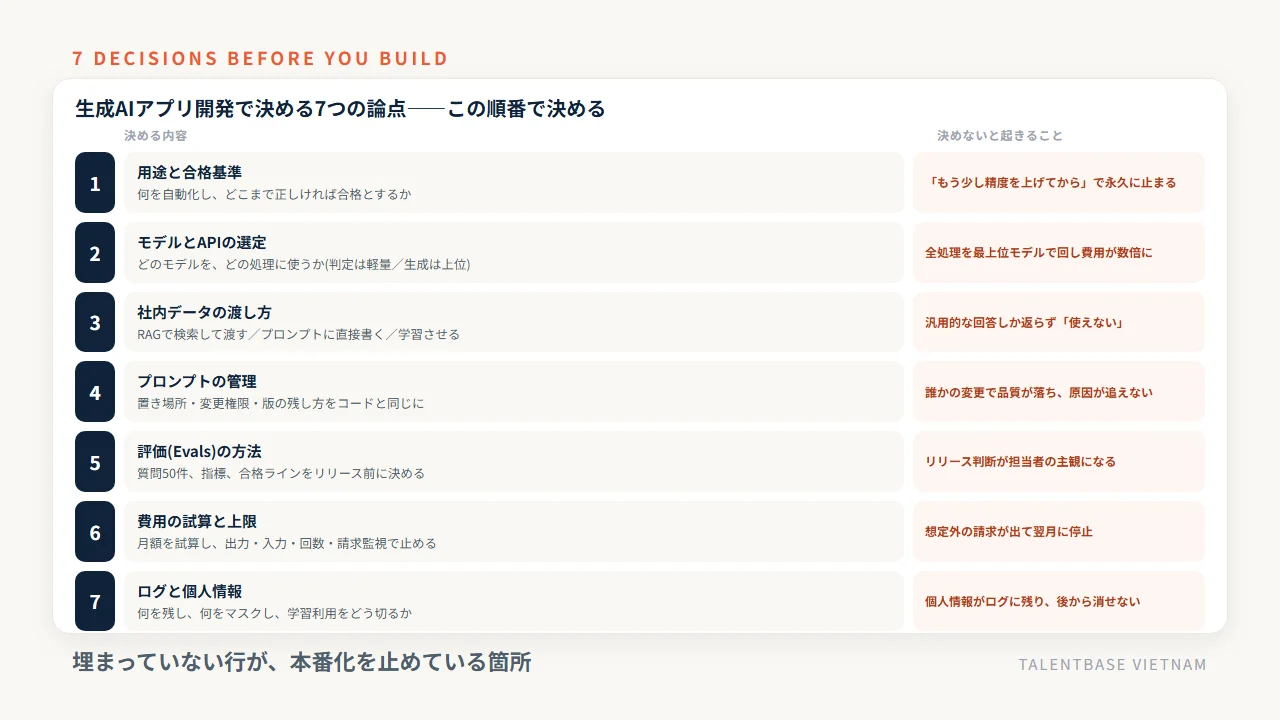
この表は、そのまま社内の検討リストとして使えます。7項目のうち埋まっていない行があるなら、その行が本番化を止めている箇所だと考えてください。
作り方の3つの選択肢——ノーコード、API組み込み、学習。まずは真ん中から
作り方は大きく3つです。DifyのようなノーコードツールでつなぐUI中心の方法、モデルのAPIを自社アプリから呼ぶ方法、自社データでモデルを追加学習させる方法。結論から言うと、業務で使うアプリの多くは真ん中のAPI組み込みで足ります。ノーコードは試作と社内検証には速い一方、既存システムとの連携や権限管理で行き詰まりやすく、学習はデータ整備と再学習の運用が重いためです。
私が相談を受けるときも、まずAPI組み込みで要件を満たせないかを確認し、それでも精度が足りない場合に学習を検討する順番を勧めています。この順番を飛ばすと、学習データの整備に数か月をかけた末に「検索して渡すだけで足りた」と分かる、という失敗が起きます。PoCと本開発の分け方や発注の進め方は「AI開発 外注」の記事で詳しく扱っていますので、外注を前提に検討している場合はあわせてご覧ください。次章から、7つの論点を順番に見ていきます。
モデルの選定とAPIの費用——価格体系とトークン課金の読み方、月額の試算と上限制御【2026年9月時点】
生成AIアプリの費用は、開発費(作るための人件費)とランニングコスト(API利用料)に分かれます。相談の場で読めないと言われるのは後者です。API利用料は処理した文字量に比例する従量課金で、単位は「トークン」。日本語では、おおむね1文字が1トークン前後に相当すると考えて概算します。料金は入力トークンと出力トークンで別建てで、出力のほうが5〜6倍高いのが各社共通の構造です。以下の金額はすべて各社公式の料金ページを2026年9月15日に確認したもので、価格改定が速い領域のため、実際に見積もる際は必ず再確認してください。
主要モデルのAPI料金(2026年9月15日 各社公式ページ確認・100万トークンあたり)
提供元 | モデル | 入力 | 出力 | キャッシュ済み入力 |
|---|---|---|---|---|
OpenAI | gpt-6-astra | 10.00USD | 50.00USD | 1.00USD |
OpenAI | gpt-5.6-sol | 4.00USD | 20.00USD | 0.40USD |
OpenAI | gpt-5.6-terra | 2.00USD | 12.00USD | 0.20USD |
OpenAI | gpt-5.6-luna | 0.20USD | 1.20USD | 0.02USD |
Anthropic | Claude Opus 5 | 5.00USD | 25.00USD | 0.50USD |
Anthropic | Claude Sonnet 5 | 2.00USD | 10.00USD | 0.20USD |
Anthropic | Claude Haiku 4.5 | 1.00USD | 5.00USD | 0.10USD |
Gemini 3.1 Pro(プレビュー) | 2.00USD | 12.00USD | 0.20USD | |
Gemini 3.6 Flash | 1.50USD | 7.50USD | 0.15USD | |
Gemini 3.5 Flash-Lite | 0.30USD | 2.50USD | 0.03USD |
出典はOpenAIの料金ページ、Anthropicの料金ページ、Google の Gemini Developer API 料金ページです。OpenAIの数値は標準ティア・短コンテキストのもので、長いコンテキストでは単価が上がります。Gemini 3.1 Proは20万トークン以下のプロンプトの価格で、これを超えると入力4.00USD・出力18.00USDになります。Gemini の Google 検索によるグラウンディングは月5,000プロンプトまで無料で、超過分は検索クエリ1,000件あたり14USDです。
読み取っていただきたいのは、同じ提供元の中に10倍以上の価格差があるという点です。最上位モデルと軽量モデルでは入力で25〜50倍、出力で10〜40倍の開きがあります。全処理を最上位モデルで回す設計は、失敗のもとです。文章の要約や分類、意図の判定といった簡単な処理は軽量モデル、最終的な文章生成だけ上位モデル、という分け方にするだけで、費用は数分の1になります。
料金表だけでは比べられない4つの理由——トークナイザ、キャッシュ、バッチ、思考トークン
同じ単価でも、実際の請求額は変わります。理由は4つです。
1つ目はトークナイザです。同じ日本語の文章でも、モデルによって何トークンに分割されるかが違います。Anthropicは公式ドキュメントで、Claude 4.7以降のモデルが新しいトークナイザを使っており、同じテキストに対しておよそ30%多いトークンを生成すると明記しています。単価が同じでもトークン数が3割増えれば、費用は3割増えます。
2つ目はプロンプトキャッシュです。毎回同じシステムプロンプトや参照文書を送る場合、キャッシュを使えば2回目以降の入力単価が大きく下がります。上表のとおり、キャッシュ済み入力は通常入力の10分の1前後です(Anthropicの Claude Fable 5.1 など一部モデルは0.025倍)。ただしキャッシュへの書き込みには通常より高い単価がかかるため、同じ内容を何度も送る場合にだけ効きます。
3つ目はバッチ処理です。即時の応答が要らない処理(夜間の一括要約など)は、バッチ用のエンドポイントに回すと安くなります。Geminiのバッチは標準の50%、OpenAIにもバッチ枠があります。
4つ目は思考トークンです。推論の過程を内部で生成するモデルでは、その分も出力トークンとして課金されます。Googleの料金ページは「出力料金(思考トークンを含む)」と明記しています。短い回答しか返らないのに出力課金が膨らむのは、これが理由であることが多いと考えてください。
月額の試算——1リクエストのトークン数×件数で概算する
試算の手順は単純です。(1)1リクエストで送る入力トークンと受け取る出力トークンを見積もる (2)月間のリクエスト件数を掛ける (3)モデルの単価を掛ける。この3段だけです。
社内問い合わせボットを例にします。社員300名が月10回質問すると、月3,000リクエスト。RAGで社内文書を3件添えると、1リクエストの入力はシステムプロンプトを含めて約6,000トークン、出力は約500トークン。月間では入力18,000,000トークン、出力1,500,000トークンになります。これを上表の単価で計算すると次のとおりです(1USD=150円換算目安)。
モデル | 入力の費用 | 出力の費用 | 月額合計 | 円換算(目安) |
|---|---|---|---|---|
gpt-6-astra | 180.00USD | 75.00USD | 255.00USD | 約38,000円 |
Claude Opus 5 | 90.00USD | 37.50USD | 127.50USD | 約19,000円 |
gpt-5.6-terra | 36.00USD | 18.00USD | 54.00USD | 約8,100円 |
Claude Sonnet 5 | 36.00USD | 15.00USD | 51.00USD | 約7,700円 |
Gemini 3.6 Flash | 27.00USD | 11.25USD | 38.25USD | 約5,700円 |
gpt-5.6-luna | 3.60USD | 1.80USD | 5.40USD | 約800円 |
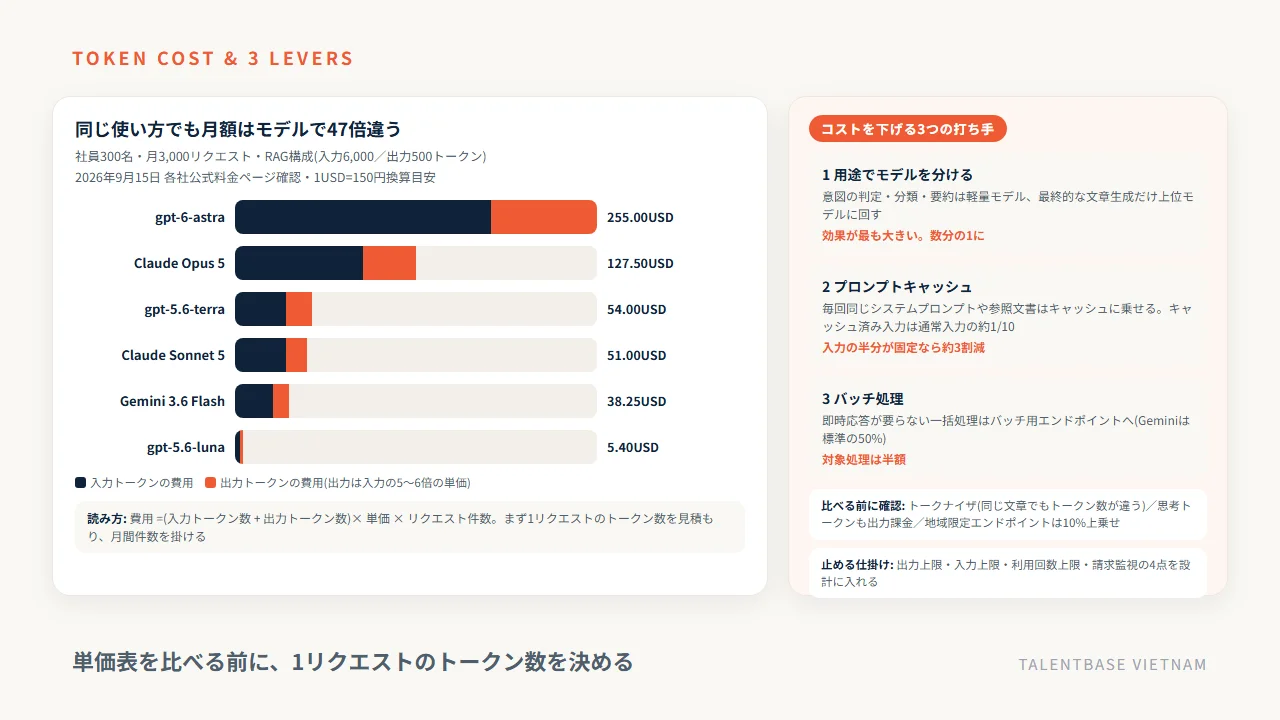
同じ使い方でも、選ぶモデルで月額が約47倍違います。さらに、6,000トークンの入力のうち半分が毎回同じシステムプロンプトなら、キャッシュを使うことで合計を約3割下げられます(Claude Sonnet 5 の例で51.00USD→約34.80USD)。この程度の金額であれば、上位モデルを使ってもランニングコストは問題になりません。問題になるのは、社外公開で件数が2桁増えたときです。
上限制御——想定外の請求を止める4つの仕掛け
従量課金で怖いのは、平均ではなく異常時です。ループする実装や、悪意のある大量アクセスで請求が跳ねます。設計時に次の4つを入れておいてください。
仕掛け | 内容 | どこに入れるか |
|---|---|---|
出力上限 | 1リクエストの最大出力トークン数を指定する | API呼び出しのパラメータ |
入力上限 | 添付する文書の件数と文字数に上限を設ける | RAGの検索処理 |
利用回数上限 | ユーザー単位・日次の回数上限を持つ | アプリ側の認証・利用記録 |
請求監視 | 予算アラートと、閾値超過時に呼び出しを止める仕組み | 請求ダッシュボード+アプリの緊急停止フラグ |
見積書を書く立場なら、この4つを「上限」として明記できるかどうかで案件の安全性が変わります。開発費そのものの相場(工程別の内訳や発注時のチェック項目)は「AI受託開発」の記事で扱っていますので、稟議の金額を組み立てる際はあわせてご覧ください。ここまでで、月額の桁は読めるようになったはずです。次は、その入力トークンの中身——社内データをどう渡すかを決めます。
社内データを答えさせる仕組み——RAGとベクトルDB、既存アプリへの後付け組み込み
モデルを選んでも、そのままでは自社のことを何も知りません。就業規則も、製品の仕様も、過去の問い合わせ履歴も学習していないからです。「それらしいが中身のない回答」しか返らないという不満の大半は、モデルの性能ではなく、自社データを渡していないことが原因です。渡し方には、プロンプトに直接書く、検索して渡す(RAG)、追加学習させる(ファインチューニング)の3つがあり、選び方には明確な基準があります。
RAGとは——検索して渡す。学習との使い分け
RAG(Retrieval-Augmented Generation、検索拡張生成)は、質問に関係しそうな社内文書を検索で取り出し、それを「参考資料」としてプロンプトに添えてからモデルに答えさせる方法です。手順は3段階で、(1)社内のPDFやWord、マニュアルを適当な長さに区切り、意味を数値の並び(ベクトル)に変換してデータベースに格納する (2)質問が来たら、質問も同じようにベクトル化し、意味の近い文書を数件取り出す (3)取り出した文書を質問と一緒にモデルへ渡す、という流れになります。
3つの渡し方の使い分けは次のとおりです。
渡し方 | 向いている場面 | 更新のしやすさ | 立ち上げの重さ |
|---|---|---|---|
プロンプトに直接書く | 参照する情報が数ページで固定(利用規約、応対ルール) | 文章を書き換えるだけ | 最も軽い |
RAG(検索して渡す) | 文書が多く、内容が更新される(マニュアル、FAQ、議事録) | 元の文書を差し替えれば反映 | 中程度。検索の精度調整が要る |
追加学習(ファインチューニング) | 独特の言い回しや出力形式を再現させたい | 再学習が必要 | 最も重い。学習データの整備に時間がかかる |
覚えておいていただきたいのは、追加学習は知識を足す手段として期待されがちですが、実際には出力の「型」を揃える手段に近いということです。更新される社内情報を答えさせたいなら、まずRAGを検討してください。当社でLLMを組み込んだ24時間対応のチャットボットを作った際も、構成はRAGです。学習には踏み込んでいません。
ベクトルDBの選び方——既存のPostgreSQLで始めるか、専用サービスを使うか
ベクトルデータベースは、文書のベクトルを保存し、意味の近いものを高速に探すための仕組みです。専用のマネージドサービスもありますが、最初から入れる必要はありません。既にPostgreSQLを使っているなら、ベクトル検索の拡張機能を入れるところから始めるのが現実的です。既存のバックアップ・権限管理・監視をそのまま使えるうえ、新しい契約も増えません。
判断の目安は文書の量と検索の速さです。数万件までなら既存DBの拡張で十分に回ります。数百万件を超える、あるいは検索に数十ミリ秒以下を求めるなら、専用サービスの検討に進みます。クラウドの標準機能(文書を置くだけでベクトル化から検索までを任せられるマネージド機能)を使う手もあり、内製の担当が1人しかいない場合はこちらが堅実です。
精度が出ないときの切り分け順——検索が悪いのか、生成が悪いのか
RAGで精度が出ないとき、いきなり上位モデルに替えるのは遠回りです。切り分けの順番があります。
- 取り出した文書に、答えが書いてあるかを目で確かめる。書いていなければ検索の問題で、モデルを替えても直りません
- 書いていなければ、文書の区切り方(長すぎる・短すぎる)、検索の件数、キーワード検索との併用を調整する
- 答えが書いてあるのに間違えるなら、はじめて生成側の問題。プロンプトで「参考資料に書かれていないことは答えない」と明示し、それでも駄目なら上位モデルを試す
この順番を守るだけで、無駄な試行がかなり減ります。私の経験では、精度が出ないという相談の多くは1と2の段階で解決します。
既存アプリへの後付け組み込み——差し込む場所と、進める順序5ステップ
既存のWebアプリやSaaSに生成AI機能を足す場合、差し込む場所はバックエンドです。ブラウザから直接モデルのAPIを呼ぶ設計にすると、APIキーが利用者に見えてしまい、利用回数の制御もできません。OpenAIの本番運用ガイドも、APIキーをコードや公開リポジトリに露出させず安全な場所に保管するよう求めています(OpenAI「Production best practices」。2026年9月21日確認)。自社サーバーに1本エンドポイントを追加し、そこから呼ぶ形にします。
進める順序は5ステップです。
順 | やること | 完了の目安 |
|---|---|---|
1 | 対象機能を1つに絞る(要約、下書き生成、分類のいずれか) | 画面のどこにボタンが付くかが決まっている |
2 | 評価用の入力と期待する出力を30〜50件用意する | 表計算ファイルに実データで揃っている |
3 | バックエンドにAPI呼び出しのエンドポイントを1本追加する | 既存の認証と利用記録に乗っている |
4 | 社内の一部ユーザーに限定公開し、フィードバックを集める | Good/Badの評価が画面から送れる |
5 | 評価データで測り直し、上限制御を入れて全体公開する | 月額の上限と回数上限が設定済み |
6 | 運用に載せ、プロンプトと文書の更新を定例に組み込む | 月1回の見直しが担当者付きで回っている |
エージェント的に複数の処理を自動で連鎖させる構成は、この5ステップが回るようになってからの話です。エージェントの構成や、それを扱える会社の見分け方は「AIエージェント開発会社」の記事に譲ります。順序を飛ばして最初から自律的な仕組みを作ろうとすると、どこで間違えたのかが追えなくなる。これが、私が現場で何度も見てきた失敗です。
プロンプトの設計とバージョン管理、ハルシネーション対策と評価(Evals)の作り方
ここが、生成AIアプリ開発で最も差がつく領域です。同じモデル、同じデータでも、プロンプトの管理と評価の仕組みがあるかどうかで、本番に出せるかどうかが分かれます。私が受ける相談で最も多い「PoCは動いたが本番に出せない」は、ほぼ例外なくこの章の話が抜けています。精度が足りないのではなく、精度を測る道具がないから合否を決められない、というのが実情です。
プロンプトはコードと同じように管理する——置き場所、変更権限、バージョンの残し方
プロンプトはアプリの挙動を決める設定であり、扱いはソースコードと同じです。ところが現場では、担当者が管理画面から直接書き換え、履歴が残らない運用になっていることが少なくありません。これでは、品質が落ちたときに「誰が、いつ、何を変えたか」を追えません。
決めるのは3点です。
決めること | 推奨 | 理由 |
|---|---|---|
置き場所 | ソースコードと同じリポジトリのファイル、または版が残る管理画面 | 変更履歴と差し戻しができる |
変更権限 | 変更はレビューを通す(業務担当が起案し、開発側が確認) | 業務の言葉と実装の制約の両方が要る |
版の残し方 | 変更ごとに版番号を振り、どの版が本番かを記録する | 品質が落ちたとき、直前の版に戻せる |
当社ではGitのプルリクエストによるコードレビューを標準化していますが、プロンプトも同じ経路に乗せています。業務担当が文言を起案し、開発側が制約(出力の形式、禁止事項、トークン数)を確認してから反映する。これだけで、原因不明の品質低下がほぼなくなります。
ハルシネーションはゼロにできない——出典表示、答えない設計、人の確認の3点で運用に収める
事実と異なる内容を自信ありげに出力するハルシネーションは、確率的に文章を生成する仕組みである以上、ゼロにはできません。「対策すれば起きなくなる」という前提で計画を立てるのは要注意です。現実的な目標は、起きる確率を下げ、起きたときに被害が出ない形にすることです。
打ち手は3つあります。1つ目は出典の表示。RAGで取り出した文書名とページを回答に添え、利用者が元資料を確認できるようにします。2つ目は答えない設計。参考資料に根拠がない場合は「該当する記載が見つかりませんでした」と返すようプロンプトで指示し、無理に答えさせないようにします。3つ目は人の確認。顧客に直接送る文面や、金額・日付を含む回答は、必ず人が承認してから外に出す導線にします。
用途によって、どこまで許容できるかは変わります。社内の調べもの補助なら多少の誤りは許容できますが、顧客への回答をそのまま自動送信する設計は、この3つ目が欠けているため勧めません。
評価(Evals)の作り方——質問と正解を50件用意し、指標と合格ラインを先に決める
評価(Evals)とは、決まった入力に対する出力の品質を、決まった指標で採点する仕組みです。作り方は難しくありません。
- 実際に来る質問を50件集める。よくある質問30件、答えられなくてよい質問10件、意地悪な質問10件の配分にする
- 各質問に、期待する回答(または回答に必ず含まれるべき要素)を書く。ここは業務担当の仕事です
- 指標を決める。代表的なのは、参考資料に忠実か(忠実性)、質問に答えているか(関連性)、根拠となる文書を取り出せているか(検索の的中率)の3つ
- 合格ラインを決める。「よくある質問30件のうち27件以上が合格、答えられなくてよい質問10件は10件とも『分かりません』と返す」といった形にする
- リリース前と、変更のたびに回す
50件という数は、多すぎず、業務担当が半日で作れる現実的な量として置いています。重要なのは件数より、リリース前に合格ラインを決めておくことです。順番が逆になると、出てきた結果を見て基準を後付けすることになり、判断が甘くなります。
採点は人が読んで判定しても構いませんし、別のモデルに採点させる方法もあります。どちらでも、同じ50件を同じ基準で繰り返せることが条件です。
プロンプトを変えたら必ず測り直す——変更のたびに回す運用
生成AIアプリでよく起きるのが、ある質問の回答を良くするためにプロンプトを直した結果、別の質問の回答が悪くなるという現象です。1か所を直すと別の場所が崩れるため、変更のたびに50件を回して、全体として良くなったかを確認する必要があります。
当社では、日本人PMの設計レビュー、Gitプルリクエストによるコードレビュー、リリース前のダブルチェックを標準の3点にしていますが、生成AI機能を含む案件ではここに評価データの実行を足しています。手作業で回しているうちは月に数回が限度なので、早い段階で自動で回せる形にしておいてください。あなたの手元には、リリースの可否を説明できる数字がありますか。
レイテンシ・ストリーミングと、ログ・個人情報の扱い——本番で効く設計
ここまでで、何を作り、どう測るかが決まりました。最後に、本番に出してから効いてくる2つの設計を決めます。速度の見せ方と、ログの残し方です。どちらも後から入れようとすると作り直しになる箇所で、着手前に方針を決めておく価値があります。
体感を決めるのは総時間ではなく最初の1文字——ストリーミングと3つの短縮策
LLMの応答は、短い回答でも数秒かかり、長い文章やRAGを挟むとさらに待たされます。従来のWebアプリの感覚では遅すぎますが、利用者が「遅い」と感じるかどうかは、実は総時間ではなく最初の1文字が出るまでの時間で決まります。全文が出そろうまで待たせる実装と、1文字ずつ流し込む実装では、総時間が同じでも体感がまったく違います。
打ち手は次の4つです。
打ち手 | 内容 | 効き方 |
|---|---|---|
ストリーミング | 生成された分から順に画面へ流す | 体感待ち時間が最も大きく縮む。まず入れる |
処理の分割 | 検索と生成を分け、検索結果を先に画面へ出す | 「探しています」の空白を埋められる |
軽量モデルの併用 | 意図の判定や分類は軽量モデルで先に処理する | 全体の応答時間が短くなり、費用も下がる |
非同期化 | 長い処理(一括要約など)は結果を後から通知する | そもそも待たせない。夜間バッチとも相性がよい |
なお、データの保存場所を特定の地域に限定する構成(データレジデンシー)を選ぶと、単価が上がる場合があります。OpenAIは対象モデルの地域処理エンドポイントに10%の上乗せがあると公式に記載しており、Anthropicも一部クラウド経由の地域限定エンドポイントで同様の上乗せを案内しています。国内保管が要件なら、費用と速度の両方に効くため、要件定義の段階で確認してください。
ログに何を残すか——障害調査に要るものと、残してはいけないもの
生成AIアプリでは、「なぜこの回答になったのか」を後から追えないと改善できません。一方で、入力をそのまま全部保存すると、利用者が貼り付けた個人情報や機密情報まで残ります。残すものと残さないものを、先に分けてください。
項目 | 扱い | 理由 |
|---|---|---|
リクエストID・日時・利用者ID | 残す | 問い合わせの特定に要る |
使用モデル・プロンプトの版番号 | 残す | 品質が変わった原因の切り分けに要る |
取り出した文書のIDとスコア | 残す | 検索が悪いのか生成が悪いのかを判定できる |
入力の本文 | 条件付きで残す(個人情報を伏せ字にしたうえで、保存期間を決める) | そのまま残すと消せなくなる |
出力の本文 | 条件付きで残す(同上) | 苦情対応に要るが、無期限は避ける |
利用者の評価(Good/Bad) | 残す | 改善の優先順位を決める唯一の実データ |
APIキー・認証情報 | 残さない | 漏えい時の被害が大きい |
伏せ字にする処理は、アプリ側で入力を受け取った直後に入れます。ログに書く直前で処理する設計にすると、途中の経路に生データが残ります。
個人情報と学習利用——契約と設定で確認する5項目
社内の機密データをモデルに渡してよいかは、法務が必ず確認する論点です。次の5つを、提供元の公開情報と契約で確認してください。
- 入力データが学習に使われるか。主要な提供元の法人向けAPIは、既定で学習に使わない方針を公開しています。無料枠や個人向けプランでは扱いが異なる場合があるため、使う枠ごとに確認が要ります
- 保存期間と保存場所。不正利用監視のために一定期間保持される場合があり、国外に保存されるかどうかも含めて確認します
- 地域の限定ができるか。前述のとおり、地域限定は費用に影響します
- 再委託の範囲。モデル提供元がさらに別のクラウドを使う構成では、経路が増えます
- 生成物の権利。生成された文章やコードの扱いを契約で確認します。開発委託の成果物としての権利は「システム開発 著作権」の記事で整理しています
委託先のセキュリティ体制そのもの(端末管理、アクセス権限、監査)は「オフショア開発 セキュリティ」の記事で扱っていますので、海外の開発チームを使う前提であればあわせて確認してください。当社は契約・支払いを日本国内法人・日本法準拠で行い、海外送金は不要にしています。ここまでの5項目を稟議の添付資料にできれば、法務との往復は1回で済むはずです。
当社の生成AIアプリ開発——AI活用開発体制とLLM組み込みチャットボットの実績、向く案件・向かない案件
最後に、当社(TALENTBASE VIETNAM)がこの領域でどう関わるかを書きます。ここまでの7つの論点を自社だけで決めきれる会社は多くありません。判断の材料を一緒に作り、実装まで担うのが当社の役割です。ただし、すべての案件に向くわけではないので、向かない場合も率直に書きます。
当社の体制と実績——日本人PMフロント、LLM組み込みチャットボット、AWS認定11冠
当社はホーチミンを拠点に、2,000名以上のIT人財データベース(日本語N1〜N2相当を含む)から直接アサインする形で、日本企業の開発チームを組んでいます。協力会社や紹介を経由しないため、仲介マージンが乗りません。公開している単価は、実務3年目安で1,500USD(約22.5万円)、5年で2,000USD、10年目安・ブリッジSEで3,000USDです(1USD=150円換算目安)。日本人PMをフロントに置く最小構成なら、2〜3人月で月額約80万円から組めます。
生成AI関連では、LLMを組み込んだ24時間対応のチャットボットを開発した実績があります。構成はRAGで、追加学習には踏み込んでいません。そのほか、決済アプリ(Stripe連携・二要素認証・ウォレット・PDF出力)、求人プラットフォーム(ATS)、ヘッドレスCMSによるWebサイトなどを手がけており、AI活用開発体制とAWS認定11冠のインフラ知見を組み合わせて設計します。品質面では、日本人PMによる設計レビュー、Gitプルリクエストによるコードレビューの標準化、リリース前のダブルチェックを標準の3点とし、生成AI機能を含む案件ではここに評価データの実行を足しています。
体制は1名から組め、最短2週間で開始、増員は約1週間、縮小や交代は1か月単位です。契約・支払いは日本国内法人・日本法準拠で、海外送金は要りません。生成AIアプリは作って終わりではなく、プロンプトと文書を更新し続ける前提なので、月額で専属チームを持つ形と相性がよい領域です。オフショアとAIの関係全般は「オフショア開発とAI」の記事で整理しています。
向く案件・向かない案件
区分 | 案件の条件 |
|---|---|
向く | 社内文書を使ったRAGの構築、既存アプリへの生成AI機能の後付け、PoCから本番化までを段階的に進めたい案件 |
向く | リリース後もプロンプトと文書を継続的に改善したい案件(月額の専属チームで持つ) |
向く | 評価データの作成から運用の型づくりまで、日本語で並走してほしい案件 |
向かない | 独自の基盤モデルを一から学習させる研究開発。当社の領域外です |
向かない | 要件が確定した単発の小規模開発。ラボ型の固定費が無駄になるため、請負での発注を勧めます |
向かない | 数十名の体制を一斉に立ち上げる大規模案件。大手SI系のほうが適します |
向かない案件にはその旨をお伝えしますので、当てはまるかどうかの相談から始めていただいて構いません。
【FAQ】生成AIアプリ開発に関するよくある質問
生成AIアプリ開発の相談でよく受ける質問を5つ挙げます。開発費そのものの相場や発注手順は既存の記事に譲り、ここでは作るときの判断に直結するものだけを扱います。
Q1. ランニングコストは月額いくらを見ておけばよいですか
社内利用であれば、多くの場合は月数千円から数万円の範囲です。本記事の試算例(社員300名・月3,000リクエスト・RAG構成)では、Gemini 3.6 Flashで約5,700円、Claude Sonnet 5で約7,700円、gpt-6-astraで約38,000円でした(2026年9月15日の公開単価・1USD=150円換算目安)。桁が変わるのは社外公開でリクエスト件数が2桁増えたときなので、想定件数を先に置いてから試算してください。
Q2. RAGとファインチューニングのどちらを選ぶべきですか
更新される社内情報に答えさせたいならRAGです。ファインチューニングは、独特の言い回しや決まった出力形式を再現させたいときの手段で、知識を足す用途には向きません。まずRAGで要件を満たせないかを確認し、それでも足りない場合に検討する順番を勧めます。
Q3. 精度は何%あれば本番に出せますか
一律の基準はなく、用途ごとに自分たちで決めるものです。社内の調べもの補助なら「よくある質問30件のうち27件以上が合格」程度で運用に載りますが、顧客へ自動送信する用途では、人の承認を挟む設計にしたうえで合格ラインを上げます。決め方の手順は本文の評価(Evals)の節に書いたとおりです。
Q4. ノーコードツールで作ったものは、後で作り直しになりますか
社内検証の範囲なら作り直しになっても構いません。ただし、既存システムとの連携、権限管理、利用回数の制御が必要になった時点で限界が来ます。本番運用を見据えるなら、評価データ(質問と期待する回答)だけはノーコードの段階から作っておいてください。これは作り直しても資産として残ります。
Q5. 社内に生成AIに詳しい人がいなくても作れますか
作れます。必要なのは技術の知識よりも、業務の言葉で「何を合格とするか」を書ける人です。技術側は外部で補えますが、評価データの正解を書けるのは業務担当だけ。当社は日本人PMがフロントに立ち、論点の整理と評価データの作成から並走する体制です。
まとめ: 7つの論点を先に決め、評価データで測り、費用に上限を置く
生成AIアプリ開発で止まるのは、技術力ではなく決めていない項目があるからです。設計時に決める論点は7つ——用途と合格基準、モデルとAPIの選定、社内データの渡し方、プロンプトの管理、評価(Evals)の方法、費用の試算と上限、ログと個人情報の扱い。この順番で決めれば、あとは普通のアプリ開発と同じ手順で本番まで進みます。埋まっていない行があるなら、その行が本番化を止めている箇所です。
費用は、用途ごとにモデルを分けるだけで数分の1になります。2026年9月15日に各社公式の料金ページで確認した100万トークンあたりの単価は、入力でgpt-6-astraが10.00USD、Claude Sonnet 5が2.00USD、Gemini 3.6 Flashが1.50USD。社員300名・月3,000リクエストのRAG構成なら、月額は約5,700円から約38,000円の幅に収まります(1USD=150円換算目安)。価格は改定が速い領域なので、見積もり時には必ず公式ページで取り直してください。そして、出力上限・入力上限・回数上限・請求監視の4つを設計に入れておけば、想定外の請求は止められます。
精度については、質問と期待する回答を50件用意し、指標と合格ラインをリリース前に決めてください。ハルシネーションはゼロにできないので、出典の表示、根拠がなければ答えない設計、人の確認の3点で運用に収めます。発注を前提に検討している場合は、PoCと本開発の分け方や受入基準を扱ったAI開発を外注する進め方、工程別の費用内訳を扱ったAI受託開発とはもあわせてご覧ください。現在の体制と要件をお聞かせいただければ、7つの論点のどこが決まっていないかの整理と、概算見積もりでお答えします。合わない案件にはその旨も率直にお伝えします。