「AI開発を外注したいが、やってみないと精度が分からないと言われて、発注の仕方が分からない」——生成AIの予算が付いた企業の担当者から、こうした相談をよく受けます。一般のシステム開発なら仕様書を書いて相見積もりを取れば進みます。ところがAIは、同じやり方で進めようとすると、見積書の前提がベンダーごとにばらばらで、比較すらできない。まずここで止まる方がほとんどです。
結論から言うと、AI開発の外注は3つを先に決めれば進みます。検証(PoC)と本開発をフェーズで分けること、PoCを始める前に「何をもって完成とするか」という受入基準を文書にすること、そして提供データ・学習済みモデル・生成物の権利を契約に書くこと。この3つです。逆に言えば、この3つを決めずに一括で発注するのが、AI開発で最も多い失敗のもとです。
AIの不確実性は、なくすものではなく、段階に分けて管理するものです。国内のAIシステム市場は2024年に前年比56.5%増の1兆3,412億円まで伸びました(出典: IDC Japan「国内AIシステム市場予測を発表」2025年5月1日。2026年9月21日確認)。一方でGartnerは2024年7月29日、データ品質・リスク統制・コスト増・事業価値の不明確さを理由に、2025年末までに生成AIプロジェクトの少なくとも30%がPoC後に放棄されると予測しました(出典: Gartner プレスリリース「Gartner Predicts 30% of Generative AI Projects Will Be Abandoned After Proof of Concept By End of 2025」2026年9月21日確認)。作れる会社は増えたのに本番に届かない。この差は、技術力ではなく発注の設計で生まれています。
本記事では、AI開発の外注が普通のシステム開発と違う3点、進め方の6ステップ、受入基準の作り方、契約形態と権利の決め方、費用の考え方と当社の体制、よくある質問の順に解説します。表はそのまま社内の稟議資料やRFPに転記できる形にしました。
私は人材業界の出身で、2018年からホーチミンでベトナムオフショア開発の体制づくりに携わり、約100社の相談に乗ってきました。AI開発の相談で最も多いのは「PoCに数百万円かけたが、レポートだけが残って本番化できなかった」というものです。原因はほぼ例外なく同じところにあります。この記事を読み終えるころには、自社のAI案件をどの順番で、どの契約で、いくらの単位で発注すればよいかが判断できるはずです。
目次
- AI開発の外注が普通のシステム開発と違う3点
- 違い1: 完成の定義を先に書けない
- 違い2: 精度を決めるのは発注側のデータ
- 違い3: リリースが始まり
- だから「フェーズを分けて発注する」
- AI開発 外注の進め方6ステップ
- 6ステップの全体像(表): 期間、発注側の作業、外注先の作業、フェーズの成果物
- ステップ1〜2は外注前に自社で固める
- ステップ4のPoCは「1業務・定量目標つき・期限つき」で出す
- PoC止まりを防ぐ判断ゲート
- 何をもって完成とするか
- 「精度◯%」だけでは検収できない理由
- 受入基準に書く5項目(表): 評価データ、指標と閾値、応答時間、外れたときの動作、人の確認工程
- 生成AIは正解が1つではない
- 契約と権利——請負が向かない理由、準委任(ラボ型)との相性、データと生成物の扱い
- フェーズ別の契約形態(表)
- 請負がAIの探索フェーズに向かない3つの理由と、ラボ型(準委任)との相性
- 契約で決める権利5項目(表): 提供データ、学習済みモデル、生成物、転用、削除と返却
- データの所在・秘密保持・再委託の確認
- 費用の考え方と、当社のAI開発体制
- フェーズ別の費用目安(表・出典付き)と、本開発を人月で読む方法
- 見積もりから抜けやすい3つ
- 当社のAI開発体制と単価(表)
- 当社に向く案件と向かない案件
- AI開発の外注に関するよくある質問
- Q1. AI開発は内製と外注のどちらがよいですか?
- Q2. PoCだけを依頼できますか?
- Q3. 精度は保証してもらえますか?
- Q4. 学習データが揃っていなくても依頼できますか?
- Q5. 最短でどのくらいで始められますか?
- まとめ: フェーズを分け、合格条件を先に決め、権利を契約に書く
AI開発の外注が普通のシステム開発と違う3点——「動いた」で終わらない、データが精度を決める、リリースが始まり
AI開発を外注するとき、一般のシステム開発と同じ手順で進めようとすると、要件定義の段階で必ず詰まります。詰まる場所は毎回同じで、3つに整理できます。完成の定義を先に書けないこと、精度を決めるのが外注先ではなく発注側のデータであること、そしてリリースが終わりではなく始まりであることです。この3つを理解しているかどうかで、見積書の読み方も契約の組み方も変わります。
違い1: 完成の定義を先に書けない——「精度◯%」だけでは仕様書にならない
一般の業務システムは、「この画面でこの項目を登録でき、この帳票が出る」と書けば、動いたかどうかで完成を判定できます。AIはそうなりません。同じデータ、同じアルゴリズムでも、学習させてみるまで期待した水準に届くか分からないからです。発注側が「精度◯%以上」とだけ書き、外注先が「達成しました」と報告しても、現場が「これでは使えない」と言う。この食い違いが、AI開発で最も頻繁に起きるトラブルです。
原因は、精度という1つの数字が業務要件を表していないことにあります。100件のうち90件を正しく判定するモデルでも、残り10件が「見逃してはいけない不良品」に偏っていれば、業務では不合格です。逆に、多少の誤検知があっても人が最終確認する運用なら、80%でも十分に使えます。つまり完成の定義は、数字ではなく「どの業務フローの中で、どんな誤りをどこまで許容し、外れたときに誰が何をするか」という形でしか書けません。ここを言語化しないまま発注するのが、失敗のもとです。
違い2: 精度を決めるのは発注側のデータ——外注先が用意できない唯一のもの
AIの結果を左右する最大の要因は、アルゴリズムでもエンジニアの腕でもなく、学習に使うデータの質と量です。そしてそのデータは、ほぼすべての案件で発注側にしかありません。過去の検査画像、問い合わせ履歴、業務マニュアル、帳票のスキャン。これらを外注先が用意することはできません。
ここが一般のシステム開発と決定的に違うところです。普通の開発なら、仕様さえ渡せば外注先が手を動かして進みます。AI開発では、データの棚卸し、抽出、匿名化、ラベル付け(アノテーション)のどれかが遅れると、その分だけプロジェクト全体が止まります。データ整備の担当者と期限を決めずに発注すると、契約は始まっているのに作業が進まない、という状態になります。外注先を選ぶときは、データ整備をどこまで手伝ってもらえるか、その作業は見積もりに含まれているかを必ず確認してください。
違い3: リリースが始まり——再学習・監視・API利用料が続く
一般のシステムは、リリースして安定すれば保守費用は下がっていきます。AIは逆で、リリース後こそ費用と手間がかかります。入力されるデータの傾向は時間とともに変わります。取扱商品が増える、問い合わせの言い回しが変わる、書式が改訂される。そのたびに精度は静かに落ちていきます。これを検知して学習をやり直す仕組み(MLOps)がないと、半年後には誰も使わない機能になります。
加えて、生成AIのAPIを使う構成では、利用量に応じた従量課金が毎月かかります。クラウドの推論基盤の費用も同様です。初期の開発費だけで会社を比べると、運用に入ってから総額が逆転することが珍しくありません。AI開発の外注は、初期費用ではなく数年分の総額で比べるものだと考えてください。
だから「フェーズを分けて発注する」——PoCと本開発を1本の契約にしない
この3つの違いから導かれる結論は1つです。AI開発の外注は、不確実性の高いフェーズと低いフェーズを分け、別々の契約で発注する。具体的には、実現できるかを確かめる検証フェーズ(PoC)と、業務で使えるものを作る本開発を、金額も契約形態も分けます。
私が相談を受けるときも、最初に確認するのは技術ではなく「いま、どのフェーズにいるか」です。何を作るかがまだ探索の段階なら、大きな一括見積もりを取ること自体が早すぎます。先に小さく確かめ、結果を見て次の投資を判断する。この順番を守れば、AI開発の不確実性は怖いものではなくなります。次章では、その順番を6つのステップに分けて具体的に見ていきます。
AI開発 外注の進め方6ステップ——課題定義からPoC、本開発、運用まで
AI開発の外注は、課題定義、データ棚卸し、ベンダー選定、PoC、本開発、運用の6段階に分かれます。各段階の境目に「次に進むかどうか」を決める判断ゲートを置くのが要点で、これがあるだけで投資判断を小刻みにできます。まずは全体像を表で押さえ、そのうえで発注側の負担が大きい前半のステップを詳しく見ていきます。
6ステップの全体像(表): 期間、発注側の作業、外注先の作業、フェーズの成果物
ステップ | 発注側の作業 | 外注先の作業 | このフェーズの成果物 |
|---|---|---|---|
1 課題定義 | 対象業務の特定、困りごとの数値化、成功の定義 | (必要なら)実現可能性の初期評価 | 課題定義書、目標とする業務指標 |
2 データ棚卸し | 使えるデータの所在・量・形式・欠損の確認、持ち出し可否の社内合意 | データ設計の助言、アノテーション方針の提案 | データ一覧、整備計画と担当・期限 |
3 ベンダー選定 | 同種案件の実績、運用体制、見積もり前提の比較 | 提案、概算見積もり、PoCの設計案 | 提案書、PoCの契約 |
4 PoC(検証) | 評価データの提供、業務側からの妥当性判断 | モデル選定、前処理、検証、精度レポート | 検証結果、本番化の可否判断 |
5 本開発 | 業務フローの調整、受入テスト、社内展開の準備 | 実装、既存システム連携、セキュリティ対応 | 本番システム、運用手順書 |
6 運用・改善 | 現場フィードバックの集約、改善の優先順位付け | 精度監視、再学習、障害対応、機能追加 | 監視レポート、改善サイクル |
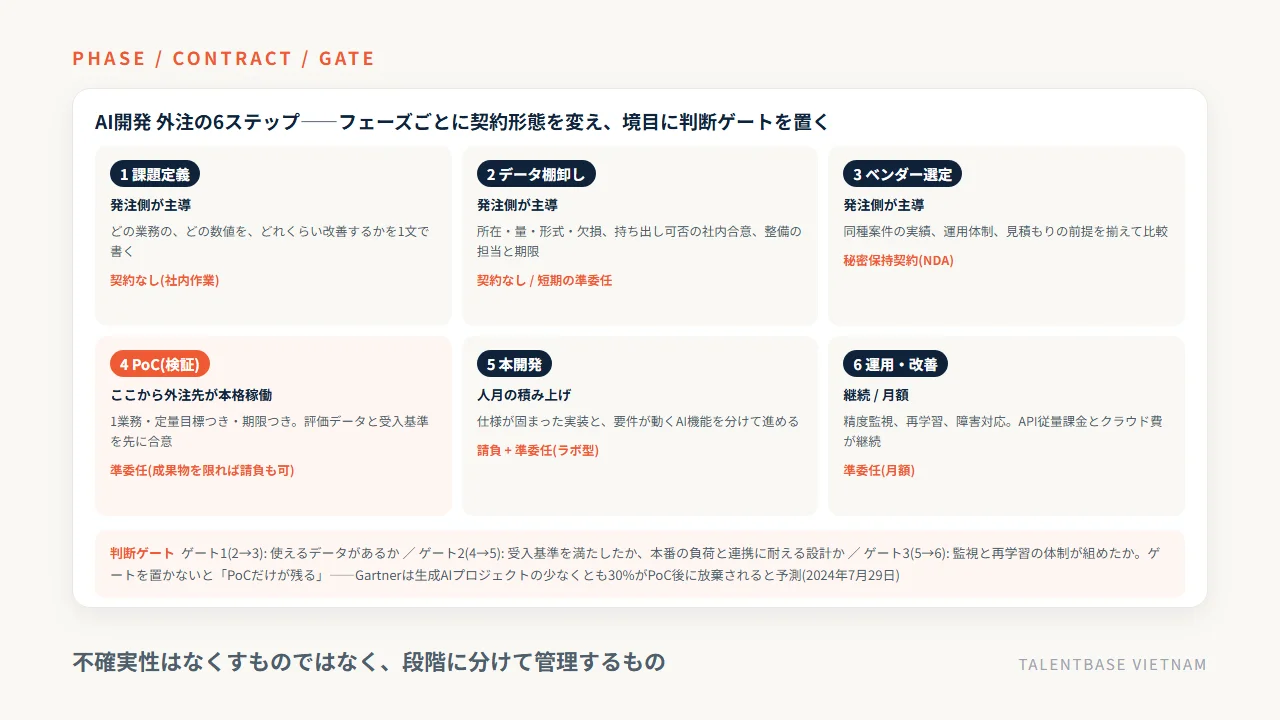
期間は業務の複雑さとデータの状態で前後します。特にステップ2は、データが社内の複数システムに散らばっている場合、棚卸しだけで2か月かかることもあります。この表で伝えたいのは個々の日数ではなく、外注先の手が本格的に動くのはステップ4以降であり、その前の1〜3は発注側が主導するということです。
ステップ1〜2は外注前に自社で固める——課題の1文化と、データの棚卸し
ステップ1で行うのは、「AIで何ができるか」ではなく「どの業務の、どの数値を、どれくらい改善したいか」を1文で書くことです。たとえば「問い合わせ対応の一次回答にかかる平均12分を、5分以下にする」。この1文があるだけで、提案の比較軸が定まり、後の受入基準もここから逆算して書けます。逆に「生成AIで業務を効率化したい」という水準の依頼書では、各社の提案がばらばらになり、比較すらできません。
ステップ2のデータ棚卸しでは、何のデータが、どこに、どれだけ、どんな形式であるかを一覧にします。あわせて、個人情報が含まれるか、社外に持ち出してよいか、誰の承認が要るかを社内で確認しておきます。ここを飛ばして契約を始めると、開発が始まってから法務や情報システム部門の確認待ちで1か月止まる、ということが起こります。データが揃っていない状態でも相談自体は可能ですが、その場合は「データ設計とアノテーションから依頼する」と最初に伝えてください。作業範囲も見積もりも変わります。
ステップ4のPoCは「1業務・定量目標つき・期限つき」で出す
PoCは、対象を1業務に絞り、定量的な目標と期限を付けて発注してください。範囲を広げると、検証が終わらないまま予算だけが消えます。当社が相談を受ける際も、最初に「今回のPoCで白黒つけたい問いは何か」を1つに絞ってもらうところから始めます。
PoCの契約時に必ず決めておくのは次の4点です。第1に、検証に使うデータの範囲と提供期限。第2に、成功と判断する条件(次章の受入基準)。第3に、成果物として何を受け取るか(検証レポートだけか、コードと学習済みモデルも含むか)。第4に、本番化に進む場合の概算と、進まない場合の終わり方です。特に第3は抜けやすく、PoCのコードが手元に残らないと、本開発を別の会社に頼むときにやり直しになります。
PoC止まりを防ぐ判断ゲート——Gartnerの30%放棄予測と、本番前提の設計
Gartnerは2024年7月29日のプレスリリースで、2025年末までに生成AIプロジェクトの少なくとも30%がPoC後に放棄されると予測し、その理由としてデータ品質の低さ、リスク統制の不備、コストの増大、事業価値の不明確さを挙げました。私が受けるAI開発の相談でも、最も多いのは「PoCに数百万円かけたが、レポートだけが残って本番化できなかった」というものです。原因はほぼ例外なく、PoCを始める前に本番化の合格条件を決めていなかったことにあります。
もう1つの原因は、PoC段階の作りが本番を想定していないことです。検証では手元のパソコンで数百件を処理すれば足りますが、本番では同時アクセス、応答時間、権限管理、監査ログが要ります。PoCの設計時点から本番の前提(想定件数、許容応答時間、接続する既存システム)を外注先に伝えておけば、作り直しの範囲が小さくなります。選定時に「PoCから本番運用まで到達した案件がどれくらいあるか」を聞くのは、この見極めのためです。
なお、要件が動き続けるプロダクトでは、PoCの後も「決めては直す」を繰り返します。当社が支援している介護記録SaaS「CareViewer」では、日本語のブリッジSE1名とフルスタックエンジニア2名の体制で、週次で優先順位を判断しながら開発を継続しています。AI機能を含む開発も同じで、月単位で方向を見直せる進め方のほうが、半年先まで仕様を固定する進め方より結果的に早く着地します。PoCは通過点であって目的ではない、というのが現場で学んだ教訓です。
何をもって完成とするか——AI開発の受入基準の作り方
AI開発の外注で最も重要な文書は、仕様書ではなく受入基準です。ここが曖昧だと、外注先は「技術的には達成した」と言い、発注側は「業務では使えない」と感じ、どちらも納得しないまま検収の話が止まります。受入基準は、精度の数字だけでなく、評価に使うデータ、外れたときの動作、人が確認する工程まで含めて書きます。この章では、その5項目の書き方を示します。
「精度◯%」だけでは検収できない理由——見逃しと誤検知はコストが違う
まず押さえたいのは、同じ精度の数字でも業務への影響がまったく違うということです。外観検査を例にすると、不良品を良品と判定してしまう見逃しは、そのまま出荷され、顧客クレームと回収費用につながります。一方、良品を不良品と判定する誤検知は、人が見直せば済み、損失は確認の手間だけです。同じ誤り率でも、誤りがどちらに寄っているかで採否が変わります。
そのため受入基準では、全体の正解率ではなく、業務上許容できない側の誤りを名指しして上限を決めます。「見逃し率は1%未満、誤検知率は15%まで許容する」といった書き方です。あわせて、その数字をどのデータで測るかを決めます。学習に使ったデータで測れば数字は良く出ますが、実務では意味がありません。学習に使っていない評価用のデータセットを、発注側が用意して固定しておくのが基本です。
受入基準に書く5項目(表): 評価データ、指標と閾値、応答時間、外れたときの動作、人の確認工程
項目 | 何を決めるか | 書き方の例 | 決めないと起きること |
|---|---|---|---|
1 評価データ | 測定に使うデータセットと件数、学習データと分けること、誰が用意するか | 直近6か月の実データ1,000件。発注側が提供し、学習には使わない | 学習データで測った良い数字が報告され、本番で再現しない |
2 指標と閾値 | 業務上許容できない誤りの種類と上限、参考指標 | 見逃し率1%未満、誤検知率15%以下、全体正解率は参考値 | 「精度◯%」の解釈が分かれ、検収で対立する |
3 応答時間・処理量 | 1件あたりの応答時間、同時実行数、1日あたりの処理件数 | 1件3秒以内、同時20人、1日5,000件 | 検証環境では動くが、本番の負荷で使えない |
4 外れたときの動作 | 判定できない場合、閾値を下回った場合の挙動 | 確信度が低い場合は「判定不能」として担当者のキューに送る | 誤った結果がそのまま業務に流れ、現場が使うのをやめる |
5 人の確認工程 | 誰が、どのタイミングで、何を確認して確定させるか | 一次回答はAI、送信前に担当者が確認、月次で外れ事例を集約 | 責任の所在が決まらず、運用開始の稟議が通らない |
この5項目は、PoCの契約時点で外注先と合意しておきます。5項目すべてを最初から数字で埋められないこともありますが、その場合は「PoCの前半2週間で仮置きし、双方で確定する」と手順のほうを決めておけば十分です。埋まっていない項目があること自体は問題ではなく、埋める時期と担当が決まっていないことが問題になります。
生成AIは正解が1つではない——評価セットとレビュー基準を先に合意する
社内文書の検索や問い合わせの一次回答のように、生成AIに文章を作らせる用途では、正解が1つに定まりません。この場合、正解率という指標自体が使えないため、評価の方法を変えます。実務でよく使うのは、想定質問と「良い回答の条件」を対にした評価セットを50〜100件作り、出力を人が採点する方法です。条件は「社内規程の該当条項を引用している」「該当する規程がない場合は、ないと答える」といった形で書きます。
ここで重要なのは、根拠のない内容を作ってしまう誤り(ハルシネーション)を、精度の問題ではなく運用設計の問題として扱うことです。出典を必ず示す構成にする、社内文書に根拠が見つからない場合は回答を拒否する、送信前に人が確認する。こうした仕組みを受入基準の第4項目・第5項目として書いておけば、モデルの完璧さに頼らずに業務へ載せられます。
当社では、AIが生成したコードや出力をそのまま納めることはしません。日本人PMによる設計レビュー、Gitのプルリクエストによるコードレビューの標準化、リリース前のダブルチェックという3段階を標準の工程として置いており、AIの出力も必ず人の目を通します。AI活用開発体制と言っても、人が確認する工程を省くという意味ではありません。むしろAIを使う開発ほど、どこで人が確認するかを先に決めておく必要があります。あなたの案件では、AIが外した1件を最初に見つけるのは誰でしょうか。この問いに答えられれば、受入基準はほぼ書けています。
契約と権利——請負が向かない理由、準委任(ラボ型)との相性、データと生成物の扱い
AI開発の外注では、契約形態をフェーズごとに変えるのが実情に合っています。完成の定義を先に書けない探索フェーズを請負で出すと、双方が無理をすることになるからです。あわせて、提供したデータと出来上がったモデル・生成物の権利は、契約に書かない限り自動的には発注側のものになりません。この章では、フェーズ別の契約形態と、契約書で決める権利5項目を整理します。
フェーズ別の契約形態(表)——探索は準委任、確定した実装は請負
フェーズ | 向く契約形態 | 理由 | 契約時に決めること |
|---|---|---|---|
課題定義・実現可能性の評価 | 準委任(短期) | 調査と助言が中心で、成果物を事前に定義できない | 期間、体制、報告の形式 |
PoC(検証) | 準委任が基本。成果物を検証レポートに限れば請負も可 | 精度が出るかは不確実で、完成を約束できない | 評価データ、受入基準、成果物の範囲、コードの帰属 |
本開発(仕様が固まった部分) | 請負 | 画面・連携・帳票など、完成を判定できる部分が中心 | 検収条件、契約不適合責任の期間、追加費用の扱い |
本開発(要件が動くAI機能) | 準委任(ラボ型) | 評価と改善を繰り返すため、月単位で方向を見直す | 体制人数、稼働の報告、優先順位の決め方 |
運用・改善 | 準委任(月額) | 監視・再学習・改善の継続作業で、終わりがない | 対応範囲、応答時間、再学習の頻度、増減員 |
1本のプロジェクトの中で契約形態が2つ3つに分かれることを、複雑だと感じるかもしれません。しかし実際は逆で、性質の違う作業を1本の契約に押し込むほうが、後で揉めます。請負と準委任の基本的な違いは、「完成を約束するか、業務の遂行を約束するか」です。詳しくは「準委任 請負 違い」の記事で整理しています。
請負がAIの探索フェーズに向かない3つの理由と、ラボ型(準委任)との相性
第1に、完成の定義が書けない仕事に完成責任は載りません。請負は成果物の完成を約束する契約なので、「精度が出るか分からない」ものを対象にすると、外注先は未達リスクを金額に上乗せするか、達成しやすい低い目標を設定するかのどちらかになります。どちらも発注側の利益になりません。
第2に、仕様変更のたびに追加見積もりが必要になり、検証のスピードが落ちます。AI開発では、データを見て初めて「この特徴量は使えない」と分かることが日常的に起こります。そのたびに見積もりの取り直しでは、1か月で回せる検証が3か月かかります。
第3に、費用の性質が合いません。探索フェーズは「何人が何か月動いたか」で費用が決まるほうが自然で、成果物単位の固定価格には収まりません。だからこそ、月額固定で専属チームを確保する準委任のラボ型が、AIの探索と改善のフェーズに向きます。当社の場合は1名から契約でき、最短2週間で開始、増員は約1週間、縮小と交代は1か月単位で調整できます。ラボ型そのものの仕組みは「ラボ型開発」の記事をご覧ください。
契約で決める権利5項目(表): 提供データ、学習済みモデル、生成物、転用、削除と返却
No | 対象 | 決めること | 決めないと起きること |
|---|---|---|---|
1 | 発注側が提供するデータ | 利用目的を本件開発に限定、他社案件や汎用モデルの学習への流用の可否、保管場所と期間 | 自社の業務データが外注先の別案件に使われる |
2 | 学習済みモデル・パラメータ | 所有と利用権の帰属、改変の可否、第三者への提供の可否 | モデルを自社で改良できず、同じ会社に頼み続けるしかなくなる |
3 | ソースコード・前処理の仕組み | 納品範囲(PoCのコードを含むか)、著作権の帰属、ドキュメントの提供 | 本開発を他社に切り替えるとき、ゼロからやり直しになる |
4 | AIが生成した出力物 | 業務での利用範囲、第三者の権利を侵害した場合の責任分担、生成物の取り扱い方針 | 公開後に権利上の指摘を受けたとき、責任の所在が決まらない |
5 | 契約終了時 | データとモデルの返却・削除、削除証明、バックアップの扱い | 契約が終わっても自社データが外部に残り続ける |
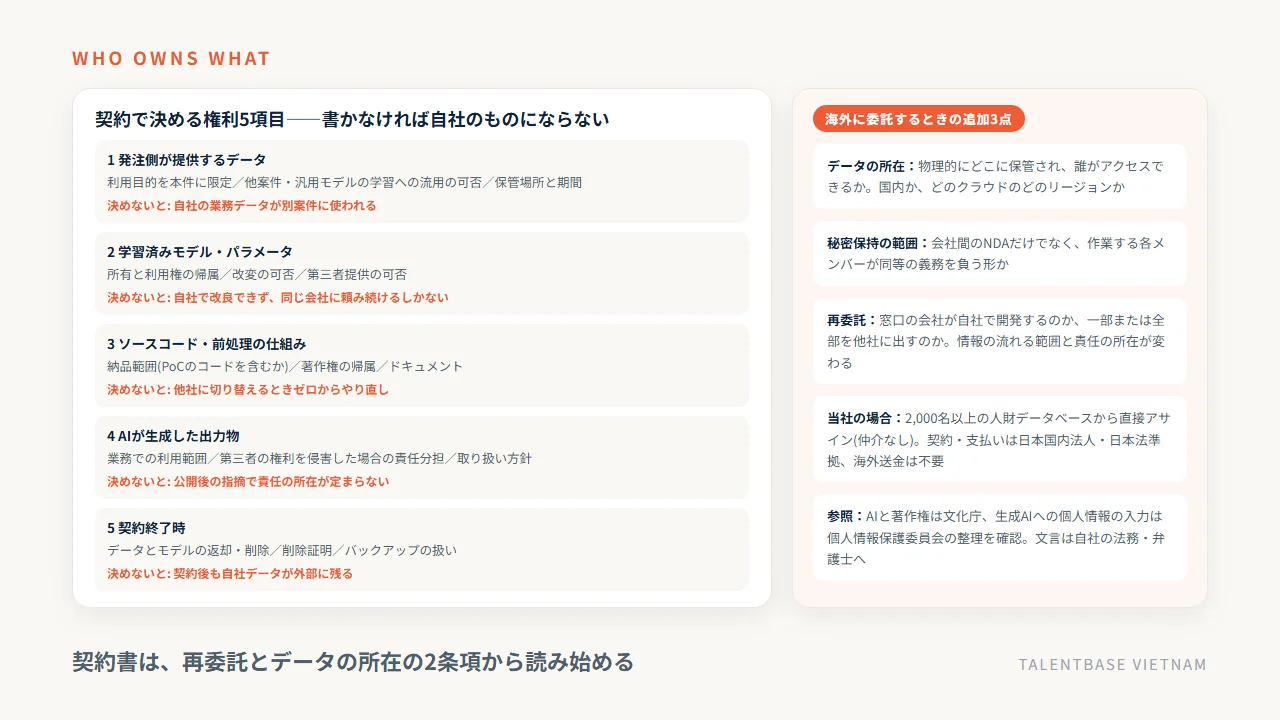
第4項目は、法制度の理解が前提になります。AIと著作権の基本的な考え方は文化庁が公開しており、個人情報を含むデータを生成AIサービスに入力する際の留意点は個人情報保護委員会が注意喚起を出しています。契約書の文言は、これらの公的な整理を踏まえたうえで、最終的には自社の法務や弁護士に確認してください。本記事の整理は発注担当者が論点を漏らさないためのもので、法的助言ではありません。知財の帰属の考え方は「知的財産 帰属」の記事でも扱っています。
データの所在・秘密保持・再委託の確認——海外で開発する場合に見るところ
海外の開発会社に委託する場合は、上の5項目に加えて3つを確認してください。1つ目は、開発データが物理的にどこに保管され、誰がアクセスできるかです。国内に置くのか、どのクラウドのどのリージョンかまで確認します。2つ目は、秘密保持の範囲が個人にまで及んでいるか。会社間のNDAだけでなく、作業する各メンバーが同等の義務を負う形になっているかを見ます。
3つ目は再委託です。窓口の会社が自社で開発するのか、一部または全部を別の会社に出すのかで、情報の流れる範囲も責任の所在も変わります。当社は2,000名以上のIT人財データベースから直接アサインしており、協力会社や紹介経由の仲介を挟みません。契約と支払いは日本国内法人・日本法準拠で、海外送金も不要です。契約書を受け取ったら、まず再委託の条項とデータの所在の条項を探す。この2つから読み始めてください。
費用の考え方と、当社のAI開発体制——PoCは数百万円、本開発は人月の積み上げ
AI開発の外注費用は、フェーズによって性質が変わります。PoCは範囲を区切った一括の費用、本開発は体制の人月を積み上げた費用、運用は月額の継続費用です。相場の一覧を眺めるより、「自社はいまどのフェーズで、その費用はどう積み上がるのか」を掴むほうが、見積書の比較には役立ちます。ここでは公開されている目安と、当社の公開単価を並べて示します。
フェーズ別の費用目安(表・出典付き)と、本開発を人月で読む方法
フェーズ | 費用の性質 |
|---|---|
PoC(概念実証) | 範囲を区切った一括。データ量とモデルの複雑さで変動 |
MVP(最小実装) | 一括または人月。API連携とUIを含む |
本番システム | 人月の積み上げ。可用性・セキュリティ・運用自動化を含む |
運用保守 | 月額。再学習・精度監視・障害対応 |
フェーズごとの金額・期間については、公的な統計も業界団体の一次調査も確認できませんでした。民間の解説記事が掲げる相場は各社が独自に集計したもので原典がないため、本稿では金額を示しません。自社の金額を出すときは、人月で読み替えてください。「必要な職種×人数×か月数×人月単価」です。オフショア開発白書2025年版(オフショア開発.com、2026年9月21日確認)では、ベトナムのプログラマーの人月単価が40.1万円、ブリッジSEが59.0万円、PMが71.4万円とされています。たとえばPM1名とエンジニア2名で6か月なら、単価だけで概算の幅が読めます。
見積もりから抜けやすい3つ——API従量課金、クラウド、アノテーションと再学習
1つ目は、生成AIのAPI利用料です。利用量に応じた従量課金で、想定利用者数と1件あたりのトークン量から月額を試算しておきます。開発費の見積書には含まれないことが多く、後から「これは実費です」と言われがちな項目です。
2つ目は、クラウドの推論基盤とデータ保管の費用です。画像や音声を扱う構成では、扱うデータ量と推論回数に比例してここが大きく膨らみます。3つ目は、データのラベル付け(アノテーション)と再学習の工数です。特にアノテーションは件数に比例して膨らむため、誰がどれだけの件数を担当するのかを最初に決めてください。見積書を受け取ったら、この3つが「含む」「含まない」のどちらで書かれているかを確認する。それだけで各社の総額が比較できる形に揃います。見積書の読み方は「見積もり 内訳」の記事でも詳しく扱っています。
当社のAI開発体制と単価(表)——AI活用開発体制、AWS認定11冠、月額約80万円〜
当社はベトナム・ホーチミンを拠点に、AIを活用した開発体制で日本企業の開発を支援しています。
項目 | 内容 |
|---|---|
体制 | パターンA(日本人PM/ブリッジSE+エンジニア・推奨)、パターンB(エンジニアのみ)。1名から、最短2週間で開始、増員は約1週間、縮小・交代は1か月単位 |
公開単価 | 実務3年目安 1,500USD(約22.5万円)、5年 2,000USD(約30万円)、10年・ブリッジSE 3,000USD(約45万円)。1USD=150円換算目安。当社調べで市場相場の約1/2 |
最小構成 | 日本人PMフロント+2〜3人月で月額約80万円〜 |
技術 | AI活用開発体制。AWS認定11冠のクラウド・生成AIスペシャリストが在籍 |
品質 | 日本人PMによる設計レビュー、Gitプルリクエストによるコードレビューの標準化、リリース前ダブルチェック |
実績 | LLMを組み込んだコンシューマー向けAIチャットボット(24時間稼働)、決済アプリ(Stripe・二要素認証・ウォレット・PDF出力)、求人プラットフォーム(ATS) |
契約 | 日本国内法人・日本法準拠。海外送金は不要。2,000名以上のIT人財データベースから直接アサインし、仲介マージンなし |
進め方は、打ち合わせ→アサイン(約1週間)→候補者面談(約1週間)→開始という流れです。AI機能のように要件が動く部分は準委任のラボ型で、仕様が固まった周辺機能は請負で、と契約を分けてご提案することもあります。
当社に向く案件と向かない案件——正直に書きます
向くのは、既存のLLMやAPIを業務システムやサービスに組み込む開発、AI機能を含むプロダクトを継続的に改善していく開発、そして評価と改善を月単位で繰り返したい案件です。AIチャットボットのように、作った後に会話ログを見ながら直し続ける類の開発とは相性がよいと感じています。
一方で、独自モデルをゼロから研究開発する案件、契約上または法令上データを国外に出せない案件、市販のSaaSを設定するだけで目的を達成できる案件は、当社には向きません。こういう案件は、研究開発に強い専業ベンダーや国内のニアショア、あるいはツールの導入支援を紹介したほうが、お客様の利益になります。合わない案件に体制を当てても、固定費と管理の手間だけが残るというのが実情です。会社のタイプ別の比較は「AI受託開発」の記事、エージェント型の開発会社の選び方は「AIエージェント 開発 会社」の記事にまとめています。
AI開発の外注に関するよくある質問
AI開発の外注について、相談の場で繰り返し聞かれる質問を5つにまとめました。社内の検討資料にそのままお使いください。
Q1. AI開発は内製と外注のどちらがよいですか?
分ける基準は「自社の競争力の源泉かどうか」です。何をAIで解決するかという課題設定と業務要件の定義は、自社にしか書けないので内製します。モデルの実装、MLOpsの構築、既存システムとの連携といった技術部分は、専門の体制を持つ外部に委託するほうが速く、採用コストもかかりません。すべてを丸投げすると社内に判断材料が残らないため、要件と受入基準は必ず自社で握ってください。
Q2. PoCだけを依頼できますか?
できます。むしろ最初はPoCだけの契約から始めることをおすすめします。その際は、検証する問いを1つに絞り、評価に使うデータと受入基準、成果物の範囲(レポートだけか、コードと学習済みモデルを含むか)、そして本番化に進む場合の概算を、契約の時点で決めておいてください。
Q3. 精度は保証してもらえますか?
一般には保証されません。学習してみるまで結果が分からないためで、これはどの開発会社でも同じです。保証の代わりに使うのが受入基準です。評価用データセット、許容できない誤りの上限、外れたときの動作、人が確認する工程の4点を合意し、その条件を満たすかどうかで判定します。逆に「精度を保証します」という提案を受けたら、どのデータで測るのかを必ず確認してください。
Q4. 学習データが揃っていなくても依頼できますか?
依頼できます。多くの開発会社が、どんなデータをどう集めるかというデータ設計や、ラベル付け(アノテーション)の段階から支援しています。ただし作業範囲と費用は変わるので、「データはこれから」と最初に伝えてください。少量のデータでも、既存の学習済みモデルを使う構成なら試せる場合があります。
Q5. 最短でどのくらいで始められますか?
当社の場合、打ち合わせからアサイン約1週間、候補者面談約1週間で、最短2週間での開始が可能です。体制は1名から組め、日本人PMフロント+2〜3人月の最小構成で月額約80万円〜。増員は約1週間、縮小と交代は1か月単位。まずは小さく始めて、結果を見てから増やすという進め方。
まとめ: フェーズを分け、合格条件を先に決め、権利を契約に書く——AI開発の外注はこの3点で決まる
AI開発の外注が一般のシステム開発と違うのは、完成の定義を先に書けないこと、精度を決めるのが発注側のデータであること、リリースが終わりではなく始まりであることの3点です。だからこそ、課題定義、データ棚卸し、ベンダー選定、PoC、本開発、運用の6段階に分け、段階の境目に判断ゲートを置いて、小さく確かめながら投資を決めていく進め方が合います。ステップ1と2は外注先に任せられない、自社の仕事です。
受入基準は、評価に使うデータ、許容できない誤りの上限、応答時間と処理量、外れたときの動作、人が確認する工程の5項目で書いてください。精度の数字だけでは検収できません。契約は、探索フェーズを準委任(ラボ型)、仕様が固まった実装を請負とフェーズごとに分け、提供データ・学習済みモデル・ソースコード・生成物・終了時の削除という5項目の権利を文書に残します。海外に委託する場合は、データの所在、秘密保持の範囲、再委託の有無を先に確認してください。法的な文言は自社の法務や弁護士にご確認ください。
費用は、PoCが範囲を区切った一括、本開発と運用は人月と月額の積み上げで読み、API従量課金・クラウド・アノテーションと再学習の3つが見積もりに含まれるかを確認すれば、各社の総額が比較できる形に揃います。当社はAI活用開発体制とAWS認定11冠のスペシャリストを擁し、日本人PMフロント+2〜3人月の最小構成で月額約80万円〜、1名から最短2週間で開始できます。費用相場と会社タイプの比較はAI受託開発とは、契約形態の違いは準委任と請負の違いもあわせてご覧ください。現在の体制と要件をお聞かせいただければ、どのフェーズから始めるべきかの判断と概算見積もりでお答えします。合わない案件にはその旨も率直にお伝えします。