「要件定義の作業に、生成AIをどこまで使えるのか」——システム開発の発注を担当されている方から、こうした相談をよく受けます。ヒアリングの議事録を整理し、用語をそろえ、機能一覧のたたき台を作る。この一連の作業に時間を取られている担当者ほど、AIに任せられないかと考えます。一方で、任せた部分で漏れが出たときに責任を負うのは自分だという感覚もあり、踏み切れないまま手を動かし続けている、というのが実情です。
結論から言うと、要件定義で生成AIが担えるのは「材料をそろえる作業」までです。議事録の整理、用語集づくり、抜け漏れの洗い出し、機能一覧のたたき台、画面項目の列挙は、AIのほうが速く、網羅的です。一方で、関係者の利害調整、優先順位の決定、業務の暗黙知の掘り起こし、責任を伴う判断は人が持ちます。この線を引かずに使うと、体裁は整っているのに誰も合意していない要件定義書ができあがります。
なお、「AIで要件定義が何割短縮できる」という数字は本記事では扱いません。出典を示せる公的なデータが見当たらないためです。効果の大小ではなく、どの作業を任せ、どの作業を引き取るかという線引きだけを書きます。
本記事では、AIが得意な作業と苦手な作業の切り分け、読ませる前に人がやる3つの準備と実際に使えるプロンプトの型5つ、出力をそのまま要件定義書にしてはいけない理由、要件定義の資料をAIに入力するときの注意、開発会社がAIを使って要件定義してくる場合に発注側が確認する6項目、よくある質問の順に解説します。入力の注意は、個人情報保護委員会と総務省・経済産業省の文書、各AI提供元の公式ポリシーを直接確認し、確認日を明記しました。
私は人材業界の出身で、2018年からホーチミンでベトナムオフショア開発の体制づくりに携わり、約100社の相談を受けてきました。ここ1年で増えているのが、「開発会社がAIで作った要件定義書を渡されたが、承認してよいか分からない」という相談です。読み終えるころには、自社の要件定義でAIをどこまで使い、どこから自分が引き取るかを決められるはずです。なお、本記事は法的な助言ではありません。個別の判断は、自社の法務や専門家にご確認ください。
目次
- 要件定義で生成AIが得意な作業と苦手な作業
- AIが得意な5つの作業と、苦手な5つの作業(一覧表)
- 線引きの理由
- 私のところに増えている相談
- AIに読ませる前の3つの準備と、要件定義で使えるプロンプトの型5つ
- 読ませる前の準備3つ
- 型1: 議事録から「決まったこと」と「宿題」を分ける
- 型2: 資料から用語集のたたき台を作る
- 型3: 観点リストを渡して抜け漏れを洗い出す
- 型4: 業務フローから機能一覧のたたき台を作る
- 型5: 画面ごとの入力項目と表示項目を列挙させる
- AIの出力をそのまま要件定義書にしてはいけない理由
- 要件定義で起きるハルシネーションの3つの型と、その見つけ方
- なぜ要件定義の誤りがいちばん高くつくのか
- 人が引き取る4つの判断
- 要件定義の資料をAIに入力するときの注意【2026年9月16日時点】
- ルール1: 個人情報を含むプロンプトは「利用目的の範囲内か」を先に確認する
- ルール2: 使うサービスの学習利用の既定を、提供元の原典で確認する
- ルール3: 他社から預かった資料と、自社の判断の記録は分けて扱う
- 開発会社がAIを使って要件定義してくる場合に、発注側が確認する6項目
- 確認6項目(表)
- 「AIを使っているから安く早い」は成り立つのか
- 差し戻すべきサインと、差し戻し方
- 当社のAI活用開発体制
- 当社の線引き
- 要件定義が固まっていない状態から相談を受ける場合、どこまで巻き取れるか
- 向く案件と向かない案件
- 要件定義とAIに関するよくある質問
- Q1. 要件定義はAIで何割くらい短縮できますか?
- Q2. 無料版のAIサービスに社内資料を入れても大丈夫ですか?
- Q3. AIが作った要件定義書の権利はどうなりますか?
- Q4. 非機能要件もAIに洗い出させてよいですか?
- Q5. 開発会社が要件定義にAIを使うことを禁止すべきですか?
- まとめ: AIに材料をそろえさせ、人が決めて合意する
要件定義で生成AIが得意な作業と苦手な作業——「材料をそろえる」は任せ、「決める」は任せない
要件定義でAIを使うかどうかを考えるとき、最初に決めるのは「どのツールを使うか」ではありません。「どの作業を任せるか」です。要件定義という工程は、ヒアリング、整理、言語化、調整、決定、合意、文書化という性質の違う作業の束でできています。このうちAIが速いのは整理と言語化で、遅いどころか成立しないのが調整と決定と合意です。まずは作業単位で線を引いてください。なお、要件定義という工程そのものの位置づけは「要件定義とは」の記事で扱っているため、ここでは繰り返しません。
AIが得意な5つの作業と、苦手な5つの作業(一覧表)
区分 | 作業 | なぜそうなるか |
|---|---|---|
得意 | ヒアリング議事録の整理(決定事項と宿題の分離) | 大量のテキストから指定した型で情報を抜き出す処理に向く |
得意 | 用語集のたたき台づくり | 資料に散らばる同義語・表記ゆれを機械的に拾える |
得意 | 抜け漏れの洗い出し(観点リストとの突き合わせ) | 網羅性のチェックは人が最も疲れる作業で、AIは疲れない |
得意 | 機能一覧のたたき台づくり | 業務フローから機能を切り出す作業は定型化しやすい |
得意 | 画面ごとの入力項目・表示項目の列挙 | 一般的な業務画面の項目は学習データに厚く含まれる |
苦手 | 関係者の利害調整 | 誰が何を諦めるかの交渉であり、当事者にしかできない |
苦手 | 優先順位の決定 | 予算・納期・経営判断という外部条件が入力に含まれない |
苦手 | 業務の暗黙知の掘り起こし | 文書化されていない運用は、そもそも入力に存在しない |
苦手 | 責任を伴う判断(この要件で作ると決めること) | AIは合意の当事者になれず、結果の責任を負えない |
苦手 | 現物の確認(実際の帳票・画面・データを見ること) | 手元の現物を見に行く行為は人の作業として残る |
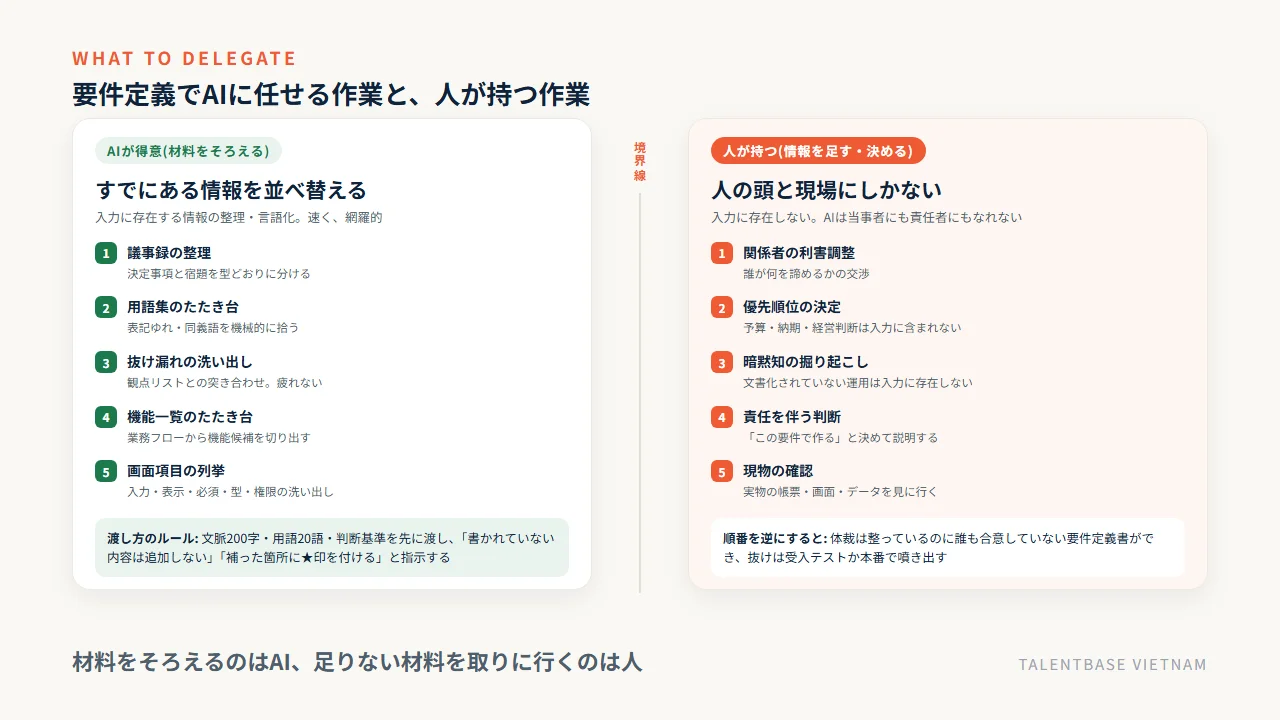
得意な5つに共通するのは「すでにある情報を、別の形に並べ替える作業」であることです。苦手な5つに共通するのは「情報を足す作業」、つまり人の頭の中や現場にしかないものを引き出す作業であることです。この区別を持っておくと、目の前の作業を任せてよいかを一瞬で判断できます。
線引きの理由——要件定義は文書づくりではなく合意づくりだから
要件定義の成果物は要件定義書ですが、工程の目的は文書を作ることではありません。立場の違う関係者が「これで作る」と合意し、後から蒸し返さない状態を作ることです。IPAが公開している「超上流から攻めるIT化の原理原則17ヶ条」でも、第4条として「ステークホルダ間の合意を得ないまま、次工程に入らない」、第9条として「要件定義は発注者の責任である」が挙げられています(IPA-SEC、一覧シートの掲載項目)。
AIは、この合意の当事者になれません。営業部門と経理部門が締め日の運用でぶつかったとき、どちらの言い分を採るかを決めるのは人であり、決めた結果を後で説明するのも人です。だからこそ、AIには材料をそろえさせ、決定と合意は人が持つ、という順番になります。順番を逆にすると、AIが出した案を関係者が黙認しただけの、合意に見える何かができあがります。
私のところに増えている相談——体裁は整っているのに、締め日の運用が抜けている
私は2018年からホーチミンでベトナムオフショア開発の体制づくりに携わり、約100社の相談を受けてきました。ここ1年で増えているのが、「開発会社がAIで作った要件定義書を渡されたが、承認してよいか分からない」という相談です。実際に見せていただくと、章立ては整い、機能一覧も網羅的で、非機能要件の項目まで並んでいます。それでも現場に持っていくと、月末の締め日にだけ発生する例外処理や、特定の取引先だけ請求書の様式が違うといった運用が、まるごと抜けています。
抜けている理由ははっきりしています。その運用はどこにも文書化されておらず、AIへの入力に存在しなかったからです。逆に言えば、入力にある情報の整理については、AIの出力は人が手作業で作るものより網羅的でした。この体験が、「材料をそろえるのはAI、足りない材料を取りに行くのは人」という線引きの根拠になっています。次章では、AIに読ませる前に人がそろえるべき3つの準備と、実際に使えるプロンプトの型を具体的に示します。
AIに読ませる前の3つの準備と、要件定義で使えるプロンプトの型5つ
AIの出力が一般論に寄る最大の原因は、モデルの性能ではなく入力側の情報不足です。前提を渡さずに「要件定義書を作って」と頼めば、学習した平均的な業務像が返ってきます。逆に、文脈・用語・判断基準の3つを先にそろえておくと、同じモデルでも出力の当たりが大きく変わります。ここでは準備の3点を示したうえで、要件定義の実作業で繰り返し使う5つのプロンプトの型を、そのまま試せる形で紹介します。要件定義の進め方そのもの(決める項目と5ステップ)は「要件定義 進め方」の記事に譲ります。
読ませる前の準備3つ——文脈・用語・判断基準をそろえる
準備1は文脈です。「誰のどの業務を、何のために変えるのか」を200字程度で書き、毎回プロンプトの先頭に貼ります。業種、対象部署、人数、現在の業務のやり方、変えたい理由、想定している利用者。この200字があるかないかで、返ってくる機能一覧の粒度が変わります。
準備2は用語です。社内でしか通じない言葉を20語だけ拾って定義を付けます。「案件」が受注前の見込みを指すのか受注後の案件を指すのか、「締め」が請求の締めなのか勤怠の締めなのか。定義しないまま渡すと、AIは一般的な意味で解釈し、出力全体がその解釈の上に積み上がります。表記ゆれの統一もここで済ませておきます。
準備3は判断基準です。何を優先し、何を捨てるかを先に決めておきます。「今回は請求業務の正確性を最優先し、画面の使いやすさは次期に回す」といった一文で十分です。これがないと、AIは全部を等しく重要なものとして並べ、優先順位のない一覧が返ってきます。優先順位を決めるのは人の仕事だという前章の線引きが、ここに効いてきます。
なお、ここで整理するのはまだ「要求」であって「要件」ではありません。両者の違いと変換の仕方は「要求定義 要件定義 違い」の記事で扱っています。
型1: 議事録から「決まったこと」と「宿題」を分ける
ヒアリングの議事録は、そのままでは要件の材料になりません。決定事項、未決事項、前提条件、発言者の主観が混ざっているためです。次の型で分離します。
【文脈】(準備1の200字を貼る)
以下はヒアリングの議事録です。次の4つに分類して表にしてください。①この場で決まったこと ②決まっていない宿題(誰が持ち帰るかも書く) ③前提として語られた業務のルール ④個人の意見・要望にとどまるもの。議事録に書かれていない内容は追加せず、判断に迷った行は「判定不能」として別表に出してください。
【議事録】(本文を貼る)
最後の一文が重要です。「書かれていない内容は追加しない」「迷ったものは分けて出す」と指示しておくと、AIが埋めてしまう余地を減らせます。
型2: 資料から用語集のたたき台を作る
準備2の用語集は、手作業で作ると時間がかかります。既存の資料があるなら、抽出から始めるほうが速いです。
以下の資料群から、社内固有と思われる用語を抽出し、表にしてください。列は「用語 / 資料中の使われ方(引用) / 想定される意味 / 表記ゆれの候補 / 確認が必要か(要/不要)」。一般的なIT用語と一般名詞は除外してください。意味が資料から判断できないものは、想定を書かずに「確認が必要」とだけ記してください。
出てきた表の「確認が必要」の行だけを現場に持っていけば、確認の会議は30分で終わります。私が支援した介護記録SaaSの案件では、この用語集を先に作っておいたことで、ホーチミンの開発チームへ仕様を渡すときの読み違いも減りました。
型3: 観点リストを渡して抜け漏れを洗い出す
「抜けている要件を教えて」と頼むと、AIは一般論を並べます。観点リストを渡し、突き合わせの形にすると精度が上がります。
以下の要件一覧を、次の観点リストと突き合わせ、記載がない観点を指摘してください。観点リスト: 権限と役割の区分 / 例外処理と差し戻し / 締め処理と月次の境界 / 過去データの移行 / 他システムとの連携 / 帳票と出力形式 / 同時操作と排他 / 性能(件数と応答時間) / 可用性と障害時の運用 / ログと監査 / 個人情報の取り扱い / 多言語と拠点差。指摘は「観点 / 記載の有無 / 想定される確認質問」の表で出し、要件の内容を勝手に補わないでください。
観点リストは自社の過去案件から作るのが理想ですが、なければ上記をそのまま使って構いません。非機能要件の書き方は「要件定義書 書き方」の記事で扱っています。
型4: 業務フローから機能一覧のたたき台を作る
業務フローが文章や図で存在するなら、そこから機能を切り出す作業は任せられます。
以下の業務フローから、システムで実現する機能の候補を抽出し、表にしてください。列は「業務ステップ / 機能名 / 入力 / 出力 / 実行する役割 / 業務フローのどの記述を根拠にしたか」。根拠の列が空になる機能は、行の末尾に「★根拠なし」と付けてください。一般的に必要とされる機能の追加提案は、本表とは別の表に分けてください。
「★根拠なし」と「別表」の2つの指示で、AIが補った部分と資料に根拠がある部分を目で見て分けられます。完成形の書式を確認したい場合は「要件定義書 サンプル」の記事で公開資料の入手先を紹介しています。
型5: 画面ごとの入力項目と表示項目を列挙させる
画面項目の列挙は、網羅性が要る割に単調な作業で、AIの向く領域です。
以下の機能一覧について、画面ごとに「入力項目 / 表示項目 / 必須か / データ型・桁 / 入力チェック / 権限による出し分け」を表にしてください。項目名は用語集(添付)の表記に合わせ、用語集にない語を新しく作った場合は末尾に「★新語」と付けてください。実際の帳票やデータを見ないと決められない項目は、値を推測せず「要現物確認」としてください。
「要現物確認」の行が、そのまま現場に持っていく確認リストになります。この5つの型は、いずれも「AIに埋めさせない」「AIが埋めた箇所に印を付けさせる」という同じ思想でできています。印のない出力をそのまま要件定義書に載せるのは失敗のもとです。次章では、その理由を具体的に説明します。
AIの出力をそのまま要件定義書にしてはいけない理由——要件定義のハルシネーションが最も高くつく
生成AIが事実でない内容をもっともらしく出力する現象は、一般にハルシネーションと呼ばれます。個人情報保護委員会も「生成AIサービスでは、入力されたプロンプトに対する応答結果に不正確な内容が含まれることがある」「当該文章は確率的な相関関係に基づいて生成されるため、その応答結果には不正確な内容の個人情報が含まれるリスクがある」と注意喚起しています(生成AIサービスの利用に関する注意喚起等、令和5年6月2日)。要件定義でこれが起きると、他の工程より損害が大きくなります。理由は、誤りが下流の全工程に乗るからです。
要件定義で起きるハルシネーションの3つの型と、その見つけ方
型 | 何が起きるか | 見つけ方 |
|---|---|---|
存在しない業務ルール | 「承認は部長が行う」など、一般的にはありそうだが自社には存在しない運用が書き込まれる | 前章の型4・型5で付けさせた「★根拠なし」「★新語」の印を全行チェックする |
実在しない規格名・法令名・条番号 | それらしい名称の規格や、実在する法律の存在しない条番号が根拠として書かれる | 固有名詞と条番号は一件ずつ原典にあたる。出典の示せない記述は削る |
根拠のない数値 | 「応答は3秒以内」「同時接続100」など、決めていない性能値が確定事項のように並ぶ | 数値はすべて「誰がいつ決めたか」を問う。答えられない数値は未決に戻す |
3つに共通するのは、書かれている内容が「もっともらしい」ことです。明らかにおかしい記述であれば誰でも気づきますが、要件定義書に書かれた一般的な業務ルールは、読み手が「そういうものか」と受け入れてしまいます。だからこそ、前章のプロンプトでAIが補った箇所に印を付けさせることが効きます。印があれば、レビューは印の行だけを見ればよくなります。
なぜ要件定義の誤りがいちばん高くつくのか——下流に伝播し、検収で出てくる
要件定義の誤りは、そこで止まりません。設計に反映され、実装され、テストケースにもなります。誤った要件から作られたテストは誤った通りに通るため、テスト工程では発見されません。発覚するのは、実際の業務に当てて使う段階、つまり受入テスト(UAT)か本番運用に入ってからです。
このとき修正に必要なのは、要件の書き直しだけでなく、設計・実装・テストのやり直しです。IPAの原理原則17ヶ条でも、第3条「プロジェクトの正否を左右する要件確定の先送りは厳禁である」として、未確定要件の先送りは現工程を延ばしてでも確定させるべきだと示されています。AIが埋めた未確定要件を確定事項の顔で通してしまうのは、先送りより悪い状態です。受入テストの進め方は「UATとは」の記事で扱っています。
人が引き取る4つの判断——現物確認、合意、優先順位、責任の所在
AIの出力を要件定義書にするまでに、人が必ず通す関門は4つです。
関門 | 誰がやるか | 通過の条件 |
|---|---|---|
1. 現物確認 | 業務担当者 | 帳票・画面・データの実物と突き合わせ、「要現物確認」の行がゼロになっている |
2. 合意 | 関係部署の責任者 | 利害が対立する項目について、どちらを採るか決めた記録が残っている |
3. 優先順位 | 発注側の意思決定者 | 予算・納期を踏まえ、今回やること・やらないことが分かれている |
4. 責任の所在 | 発注側の承認者 | 「この要件で作る」と承認した人の名前が文書に載っている |
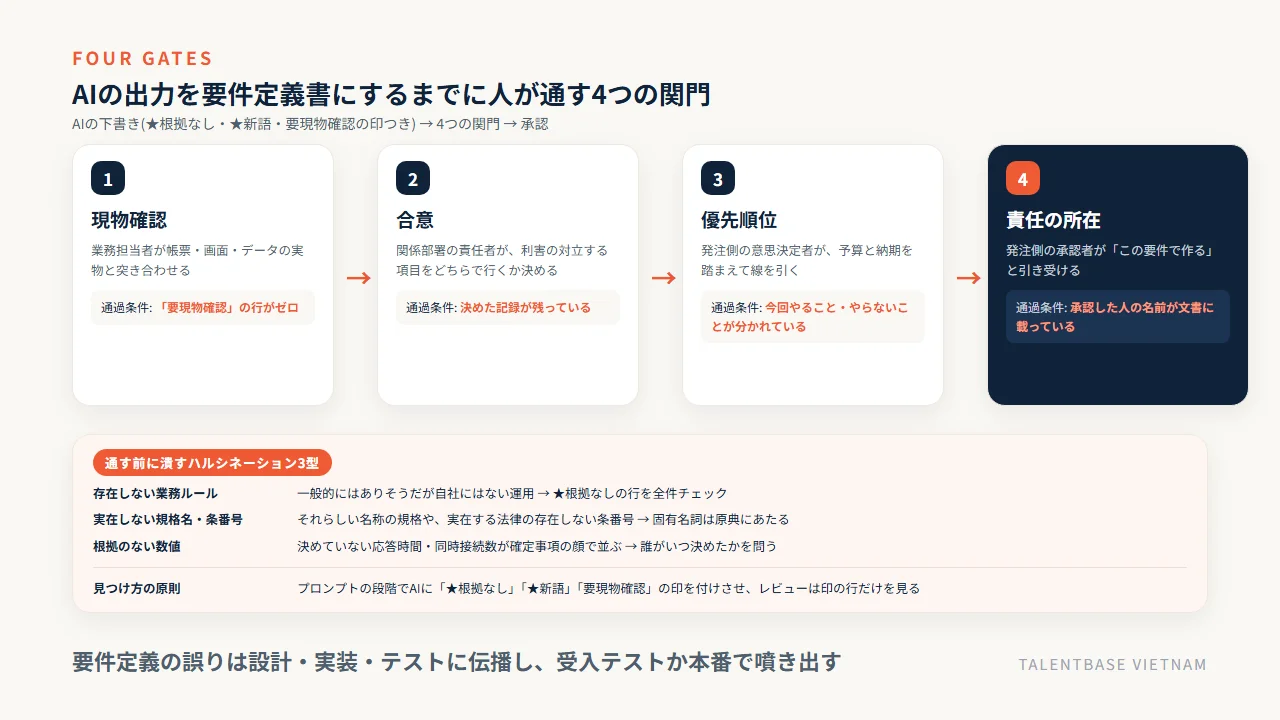
この4つのうち、AIが代行できるものはひとつもありません。IPAの原理原則でも第17条として「要件定義は説明責任を伴う」が挙げられ、発注者側の行動規範として「要件を正しく説明する」ことが求められています。AIが書いた文章を、書いた本人が説明できない状態で承認するのは要注意です。
私が見てきた失敗は、この4つの関門のうち1番目と2番目を飛ばしたものばかりです。体裁が整った文書が先にできてしまうと、「もうできている」という空気が生まれ、現場に確認しに行く動機が弱まります。文書ができる速さが上がったぶん、確認を飛ばす誘惑も強くなった、というのが実情です。AIを使うなら、浮いた時間は現場の確認と関係者の調整に回してください。
要件定義の資料をAIに入力するときの注意【2026年9月16日時点】——一次情報で確認した3つのルール
要件定義の資料は、業務フロー、現行システムの画面や帳票、顧客対応のログ、社内規程の抜粋など、社内情報のかたまりです。「機密情報は入力しない」という一行だけの社内ルールでは、これらが該当するのかどうか判断できません。ここでは公的機関の文書とAI提供元の公式ポリシーを直接確認し、確認日を付けて3つのルールに整理します。以下は2026年9月16日時点で各原典を確認した内容であり、法的な助言ではありません。個別の判断は自社の法務や専門家にご確認ください。生成AI全般の危険性と社内ルールのひな形は「ChatGPT 危険性」の記事で扱っています。
ルール1: 個人情報を含むプロンプトは「利用目的の範囲内か」を先に確認する
個人情報保護委員会は、令和5年6月2日に「生成AIサービスの利用に関する注意喚起等」を公表しています。個人情報取扱事業者に対する注意点として、次の2つが挙げられています。
- 生成AIサービスに個人情報を含むプロンプトを入力する場合には、特定された当該個人情報の利用目的を達成するために必要な範囲内であることを十分に確認すること
- あらかじめ本人の同意を得ることなく個人データを含むプロンプトを入力し、当該個人データがプロンプトに対する応答結果の出力以外の目的で取り扱われる場合、個人情報保護法の規定に違反することとなる可能性がある。そのため、当該生成AIサービスを提供する事業者が、当該個人データを機械学習に利用しないこと等を十分に確認すること
要件定義の資料でこれに当たりやすいのは、顧客対応のログ、取引先の担当者名が入った議事録、従業員の勤怠データのサンプルです。実務上の対処はシンプルで、入力する前に個人が特定される記述を仮名に置き換えることです。要件定義に必要なのはデータの構造と業務の流れであって、実在する個人の値ではありません。
ルール2: 使うサービスの学習利用の既定を、提供元の原典で確認する
同じ注意喚起では、一般の利用者に対する留意点として「生成AIサービスを提供する事業者の利用規約やプライバシーポリシー等を十分に確認し、入力する情報の内容等を踏まえ、生成AIサービスの利用について適切に判断すること」が示されています。まとめ記事ではなく提供元の原典にあたる、というのがここでの指示です。当社で2026年9月16日に確認した主要3社の記述は次の通りです。
提供元 | 対象 | 公式ドキュメントの記述(2026年9月16日確認) |
|---|---|---|
OpenAI | API | 「APIに送信されたデータは、明示的にオプトインしない限り、モデルの学習や改善に使用されない」。不正利用監視のログは既定で最大30日保持。承認制のゼロデータ保持(Zero Data Retention)では顧客コンテンツが監視ログから除外される |
Anthropic | 商用製品(Claude for Work、API等) | 「既定では、商用製品の入力および出力をモデルの学習に使用しない」。ユーザーが明示的にフィードバックを送った場合は例外となりうる |
Google Workspace の生成AI機能 | 「Workspaceは、顧客の事前の許可または指示なしに顧客データをモデルの学習に使用しない」「許可なくドメイン外での生成AIモデルの学習に使われることも、人によるレビューを受けることもない」 |
重要なのは、同じ提供元でも契約形態(消費者向けかビジネス向けか)で既定が変わりうることです。上表はいずれもビジネス向け・API向けの記述であり、個人アカウントで無料版を使う場合の既定とは異なります。社内で使う場合は、契約しているプランの名前で原典を確認し、確認日を社内ルールに書き残してください。ポリシーは改定されます。
ルール3: 他社から預かった資料と、自社の判断の記録は分けて扱う
総務省と経済産業省が公表している「AI事業者ガイドライン」は、2026年9月16日時点の最新が第1.2版(令和8年3月31日公表)です。AI開発者・AI提供者・AI利用者の3主体を区分し、人間中心、安全性、公平性、プライバシー保護、セキュリティ確保、透明性、アカウンタビリティなどの共通の指針を示しています。発注側の担当者は、このうち「AI利用者」に当たります。
実務に落とすと、要件定義で扱う情報は3つに分けて考えると整理しやすくなります。(1)自社が作った資料、(2)他社から秘密保持契約のもとで預かった資料、(3)個人情報を含むデータ。(2)は契約上、第三者のサービスへの入力が制限されている場合があるため、契約書の再委託・第三者提供の条項を先に読んでください。(3)はルール1の通りです。(1)についても、判断の経緯や社内の対立の記録といった、外に出す前提のない情報は入力しない運用にしておくほうが安全です。AIを使うかどうかではなく、何を入れるかで線を引く。これが実務で回るやり方です。
開発会社がAIを使って要件定義してくる場合に、発注側が確認する6項目
開発会社が上流工程でAIを使うこと自体は、悪いことではありません。議事録の整理や機能一覧のたたき台づくりが速くなれば、その時間を確認と調整に回せます。問題になるのは、AIが埋めた部分と人が確認した部分が区別されないまま納品されるときです。発注側が見るべきは「AIを使ったかどうか」ではなく「AIが埋めた箇所が分かるようになっているか」です。以下の6項目を、契約前の提案段階と、要件定義書の納品時の2回確認してください。実装工程でのAI活用(AI駆動開発)の確認事項は「AI駆動開発 外注」の記事で別に整理しています。
確認6項目(表)
No | 確認すること | 具体的な聞き方 | 望ましい答え |
|---|---|---|---|
1 | 出典の明示 | 「各要件は、どの資料・どの発言を根拠にしていますか」 | 根拠の列があり、根拠のない行に印が付いている |
2 | 確認済みと未確認の区別 | 「現場に確認が取れている項目と、まだの項目はどう分かれていますか」 | 別表か印で分かれており、未確認の件数を即答できる |
3 | 入力した情報 | 「当社が渡した資料を、どのAIサービスに、どの契約プランで入力しましたか」 | サービス名・プラン名・学習利用の既定を答えられる |
4 | レビュー体制 | 「AIの出力を誰がレビューしましたか。その方は業務を理解していますか」 | 名前のある担当者が、根拠の列を1行ずつ見ている |
5 | 成果物の権利 | 「要件定義書の著作権と、再利用の範囲はどうなりますか」 | 契約書の知的財産条項に、生成AI利用時の扱いが書かれている |
6 | 差し戻しの扱い | 「現場確認で要件が変わった場合、費用と期間はどうなりますか」 | 要件定義フェーズ内での修正回数と扱いが決まっている |
6項目のうち、実際に差が出るのは1と2です。根拠の列がある要件定義書は、人が作ってもAIが作っても検収できます。逆に、根拠の列がなく、全項目が同じ確度で並んでいる文書は、どこから確認してよいか分からず、結果として全部を読み直すことになります。この差は、レビューにかかる発注側の工数として跳ね返ります。
「AIを使っているから安く早い」は成り立つのか——速くなる工程と、変わらない工程
見積もりを読むときに分けて考えてほしいのは、速くなる工程と変わらない工程です。速くなるのは、議事録の整理、文書化、一覧の作成、表記の統一といった文書作業です。変わらないのは、現場のヒアリングにかかる時間、関係部署の合意を取る時間、経営層の承認を待つ時間です。後者は人と組織のスケジュールで決まるため、AIを入れても短くなりません。
したがって、「AIを使っているので要件定義の期間を半分にします」という提案を受けたら、その半分が文書作業の削減なのか、確認と合意の圧縮なのかを聞いてください。後者であれば、削られているのは費用ではなくリスクの吸収代です。なお当社は、AI活用を理由に上流工程の期間短縮を約束していません。約束しているのは、材料の整理を速くしたぶんを確認に回すことだけです。
差し戻すべきサインと、差し戻し方
受け取った要件定義書に次のサインがあれば、いったん差し戻して構いません。(1)例外処理がどの業務でも同じ書き方で並んでいる、(2)自社の固有名詞が一般名詞に置き換わっている(「案件管理」が「プロジェクト管理」になっているなど)、(3)性能値や件数に出典がない、(4)根拠の列そのものがない。
差し戻すときは、「AIで作ったのではないか」とは言わずに、「この行の根拠となった資料か発言を教えてください」と項目単位で聞くのが実務的です。根拠を示せる行と示せない行が分かれば、その後の作業は自然と整理されます。逆に、この問いに答えられない開発会社と上流を一緒にやるのは、AIの利用有無にかかわらず失敗のもとです。あなたの手元の要件定義書は、どの行まで根拠を示せるでしょうか。
当社のAI活用開発体制——上流工程でAIをどこまで使い、どこは人が持つか
最後に、当社がどう線を引いているかをお伝えします。当社はベトナム・ホーチミンを拠点に、日本人PMとベトナム人エンジニアでラボ型の開発チームを組む会社で、AI活用開発体制を品質管理の3点(日本人PMの設計レビュー、Gitプルリクエストによるコードレビューの標準化、リリース前のダブルチェック)とあわせて運用しています。売り込みのためではなく、前章までの線引きを実際の体制に落とすとどうなるかの一例として読んでください。
当社の線引き——AIに任せる作業と、日本人PMが持つ作業
工程の作業 | 担い手 | 理由 |
|---|---|---|
打ち合わせ議事録の整理、決定事項と宿題の分離 | AIで下書き→日本人PMが確認 | 速く、かつ確認の対象が明確になる |
用語集のたたき台、日越の対訳づくり | AIで下書き→BrSEが確認 | 表記ゆれの検出はAIが速い。訳語の妥当性は人が見る |
機能一覧・画面項目のたたき台 | AIで下書き→日本人PMが根拠を確認 | 根拠のない行に印を付けたうえでレビューする |
決定事項の確定と、お客様への確認 | 日本人PMのみ | 合意の当事者は人でなければならない |
優先順位の判断 | お客様と日本人PMの協議 | 予算・納期・事業判断が入力に含まれない |
現物(帳票・画面・データ)の確認 | お客様と日本人PM | 現物を見に行く作業は残る |
考え方はコードレビューと同じです。誰が書いたかにかかわらず、業務を理解している人のレビューを通してから確定させる。AIの出力を例外にしない、というだけのことです。
要件定義が固まっていない状態から相談を受ける場合、どこまで巻き取れるか
「要件定義書がまだない」という段階のご相談も受けています。この場合、当社の日本人PMが打ち合わせに入り、業務の整理、機能の洗い出し、優先順位の案出しまで伴走します。ただし、決めるのはお客様です。当社が作るのは判断材料であって、判断そのものではありません。実際、介護記録SaaS「CareViewer」の案件では、日本語対応のブリッジSE1名とフルスタックエンジニア2名の体制で、週次で優先順位を判断しながら継続開発を進めています。仕様が動く前提の案件ほど、この形が合います。
体制は1名から組め、日本人PMをフロントに置く構成(パターンA)と、エンジニアのみの構成(パターンB)があります。公開している単価は実務3年目安で1,500USD(約22.5万円)、5年で2,000USD、10年目安・ブリッジSEで3,000USD(いずれも1USD=150円換算目安)。日本人PMフロント+2〜3人月の最小構成で月額約80万円〜です。契約と支払いは日本国内法人・日本法準拠で、海外送金は不要です。
向く案件と向かない案件
向くのは、要件が動く前提で継続的に開発する案件、上流から一緒に整理してほしい案件、既存システムの改修で現物の確認が多い案件です。向かないのは、要件が完全に確定していて成果物単位で費用を固定したい単発案件(請負のほうが合います)と、発注側に優先順位を判断する担当者を置けない案件です。後者は、AIを入れても解決しません。決める人がいない状態で材料だけ増えると、かえって前に進まなくなるためです。
要件定義とAIに関するよくある質問
要件定義でのAI活用について、相談の場で繰り返し聞かれる質問を5つにまとめました。社内で方針を決めるときの材料にお使いください。
Q1. 要件定義はAIで何割くらい短縮できますか?
出典を示せる公的なデータは、2026年9月16日時点で見当たりません。そのため当社は具体的な割合を申し上げていません。実感としては、議事録の整理や一覧の作成といった文書作業は明確に速くなり、現場のヒアリング、関係部署の合意、経営層の承認にかかる時間は変わりません。期間短縮を提案されたら、どちらが削られているのかを確認してください。
Q2. 無料版のAIサービスに社内資料を入れても大丈夫ですか?
契約しているプランの公式ポリシーを、その都度確認してください。ビジネス向けのプランやAPIでは「既定では学習に使わない」と明示している提供元が多い一方、消費者向けの既定は製品ごとに異なります。個人情報を含む場合は、個人情報保護委員会の注意喚起(令和5年6月2日)にある通り、利用目的の範囲内かと、機械学習に利用されないかの2点を確認してください。実務上は、個人が特定される記述を仮名に置き換えてから入力するのが安全です。
Q3. AIが作った要件定義書の権利はどうなりますか?
契約で決めることです。要件定義書を開発会社が作成する場合、著作権の帰属と再利用の範囲は業務委託契約の知的財産条項で定めます。生成AIを使って作成した成果物の扱いを条項に書いていない契約も多いため、締結前に確認してください。判断に迷う場合は自社の法務や専門家にご相談ください。本記事は法的な助言ではありません。
Q4. 非機能要件もAIに洗い出させてよいですか?
観点の洗い出しには使えます。性能・可用性・セキュリティ・運用といった観点リストとの突き合わせは、AIが得意な作業です。ただし、具体的な数値(応答時間、同時接続数、稼働率)をAIに決めさせてはいけません。数値は業務の実態と予算から人が決めるものです。AIが出した数値がそのまま残っていないか、出典を1件ずつ確認してください。
Q5. 開発会社が要件定義にAIを使うことを禁止すべきですか?
禁止より、区別を求めるほうが実務的です。禁止しても、根拠のない行が混ざるリスクはなくなりません。求めるべきは、各要件の根拠の明示と、現場確認済みかどうかの区別、そして入力したサービスと契約プランの開示の3点。あわせて、レビューを担当した人の名前を明らかにしてもらうこと。
まとめ: AIに材料をそろえさせ、人が決めて合意する——要件定義でAIを使う順番
要件定義で生成AIが担えるのは、材料をそろえる作業までです。議事録の整理、用語集づくり、観点リストとの突き合わせによる抜け漏れの洗い出し、機能一覧のたたき台、画面項目の列挙は任せられます。一方で、関係者の利害調整、優先順位の決定、業務の暗黙知の掘り起こし、責任を伴う判断、現物の確認は人が持ちます。得意な作業に共通するのは「すでにある情報を並べ替えること」、苦手な作業に共通するのは「人の頭と現場にしかない情報を足すこと」です。
使うときは、文脈・用語・判断基準の3つをそろえてから読ませ、プロンプトには必ず「書かれていない内容は追加しない」「補った箇所には印を付ける」と指示してください。出力をそのまま要件定義書にするのは失敗のもとです。存在しない業務ルール、実在しない規格名や条番号、根拠のない性能値という3つの型で誤りが混ざり、それらは設計・実装・テストに伝播して受入テストか本番で噴き出します。現物確認・合意・優先順位・責任の所在という4つの関門は、人が通してください。社内資料を入力する前には、個人情報を含むプロンプトが利用目的の範囲内かを確認し、契約しているプランの公式ポリシーを原典で確認する。開発会社がAIで要件定義してくる場合は、AIの利用可否ではなく、各行の根拠と現場確認済みかどうかの区別を求めるのが実務的です。
当社は上流工程で、議事録の整理・用語集・機能一覧のたたき台にAIを使い、決定事項の確定と関係者への確認、優先順位の判断は日本人PMが持つ形にしています。コードレビューと同じで、誰が書いたかにかかわらず業務を理解している人のレビューを通す、というだけのことです。要件定義そのものの全体像は要件定義とは、要件定義書の章立てと書き方は要件定義書の書き方もあわせてご覧ください。なお本記事は法的な助言ではなく、個別の判断は自社の法務や専門家にご確認ください。現在の体制と要件をお聞かせいただければ、上流工程をどこまで巻き取れるかの判断と、概算見積もりでお答えします。合わない案件にはその旨も率直にお伝えします。