「サービスが落ちた。原因が分からないし、自分は何をすればいいのか」——障害の最中に、こうした連絡をいただくことがあります。顧客からの問い合わせが増えていく。経営層から「いつ直る」と聞かれる。委託先には電話がつながらない。技術的なことは分からないのに、説明だけは自分の仕事として回ってくる。この状態が、サーバー障害でいちばん苦しい時間です。
結論から言うと、事業側の担当者が最初の5分でやるべきことは、原因を当てることではありません。誰が・いつから・どこまで影響を受けているかを確定すること、直前に何を変えたかを確認すること、そしてユーザーと社内への連絡経路を一本化することの3つです。原因の切り分けには「外から内へ」という決まった順番があり、その順番さえ持っていれば、技術者でなくても委託先に何を聞けばよいかが分かります。
原因そのものは、9つの類型に整理できます。リソースの枯渇、アプリのバグとメモリリーク、データベースのロックとスロークエリ、ネットワークとDNS、証明書の失効、外部APIの障害、デプロイ起因、アクセス集中、そしてクラウド側の障害です。症状が「遅い」のか「つながらない」のかで、疑う場所は変わります。そしてクラウドを使っていれば落ちない、ということもありません。AWS は2025年10月に米国東部リージョンで大規模な障害を起こし、公式レポートで DNS管理システムの不具合を根本原因として説明しています。
本記事では、最初の5分でやること、原因9類型と症状からの切り分け、一次対応の順番とユーザーへの告知の出し方、復旧後の原因究明と監視の最低限、保守契約で決めておく6項目、よくある質問の順に解説します。稼働率やSLAの数値は、AWS・Google Cloud・Microsoft の公式ページを2026年9月15日に直接確認したものだけを載せ、「99.9%が年間何分にあたるか」は自分で計算して示しました。
私は人材業界の出身で、2018年からホーチミンでベトナムオフショア開発の体制づくりに携わり、約100社の相談に乗ってきました。相談の相当数は「作ったあと」の話です。障害の最中に事業側が技術判断をしようとすると、復旧も説明も両方遅れるというのが実情です。この記事を読み終えるころには、落ちたときに自社が何をして、委託先に何を任せ、契約で何を決めておくべきかが整理できるはずです。
目次
- サーバー障害が起きたら最初の5分でやること
- まず確かめる4つ
- 切り分けは「外→内」の順番で見る
- 非エンジニアでもできる確認3つ
- やってはいけない3つ
- サーバー障害の原因9類型
- 原因9類型の対応表(症状・典型的な原因・最初に見る場所・一次対応)
- 「遅い」と「つながらない」で疑う場所が変わる
- 変更と負荷を先に疑う
- 自社では直せない原因
- 一次対応の順番と、ユーザーへの告知の出し方
- 一次対応の5ステップ
- 告知は3回に分けて出す
- 告知文に入れる7要素
- 社内の連絡経路と4つの役割
- 復旧後の原因究明と再発防止
- 振り返りで書く6項目
- 再発防止は3方向で考える
- 監視の最低限5つ
- アラートは「人を起こす基準」で設計する
- 保守契約で決めておく6項目と、外部チームで運用を持つときの体制(当社の場合)
- 決めておく6項目(受付時間、一次対応の定義、復旧目標、連絡経路、エスカレーション、記録)
- 稼働率の数字は「年間何分止まってよいか」に直して読む
- 当社の体制——週次保守、時差2時間で日本の営業時間と重なる。24時間365日は持たない
- 向く案件・向かない案件
- サーバー障害の原因と対応に関するよくある質問
- Q1. 原因が分からないまま復旧してしまいましたが、このまま様子を見てよいですか
- Q2. ユーザーへの告知は、原因が特定できてから出すべきですか
- Q3. 提案書に「稼働率99.9%」とありました。これは十分な水準ですか
- Q4. 監視は何から始めればよいですか。予算が限られています
- Q5. クラウド側の障害で自社サービスが止まった場合、責任は誰にありますか
- まとめ: 原因を当てる前に影響範囲を確定する
サーバー障害が起きたら最初の5分でやること——原因を当てる前に、影響範囲を確定する
サーバー障害が起きたとき、事業側の担当者が最初にやろうとするのは「原因を突き止めること」です。しかし、これは順番が逆です。原因の調査は、ログとサーバーに触れる人の仕事です。事業側がやるべきなのは、影響範囲を確定し、連絡経路を一本化し、ユーザーに何を伝えるかを決めること。この3つは技術知識がなくてもでき、しかも被害を最も小さくします。最初の5分の使い方を決めておいてください。
まず確かめる4つ——誰が・いつから・どこまで・直前に何を変えたか
障害の報告を受けたら、次の4つを紙かチャットに書き出します。この4行が、そのまま社内報告とユーザー告知の材料になります。
確かめること | 具体的に聞く・見ること | なぜ必要か |
|---|---|---|
誰が | 全ユーザーか、一部の顧客か、社内だけか。特定の地域や端末に偏っていないか | 全滅なら外側の層、一部なら内側の層が疑わしい。切り分けの出発点になる |
いつから | 最初の問い合わせの時刻、監視アラートの発報時刻 | 直前に何が起きたかを探す基準時刻になる。告知にも必ず書く |
どこまで | 全機能か、ログインだけか、決済だけか。見られるが書き込めない状態か | 縮退運転(一部機能を止めて残りを生かす)ができるかの判断材料 |
直前に何を変えたか | デプロイ、設定変更、キャンペーンの開始、外部サービスの切り替え、証明書やドメインの更新期限 | 障害の多くは「直前の変更」に紐づく。ここで当たれば復旧が一気に速くなる |
4つ目の「直前に何を変えたか」は、事業側だからこそ答えられる項目です。委託先はキャンペーンの開始時刻を知りません。テレビで紹介された、メールを一斉送信した、大口顧客が一括取り込みを始めた——こうした情報は、事業側から出すしかありません。
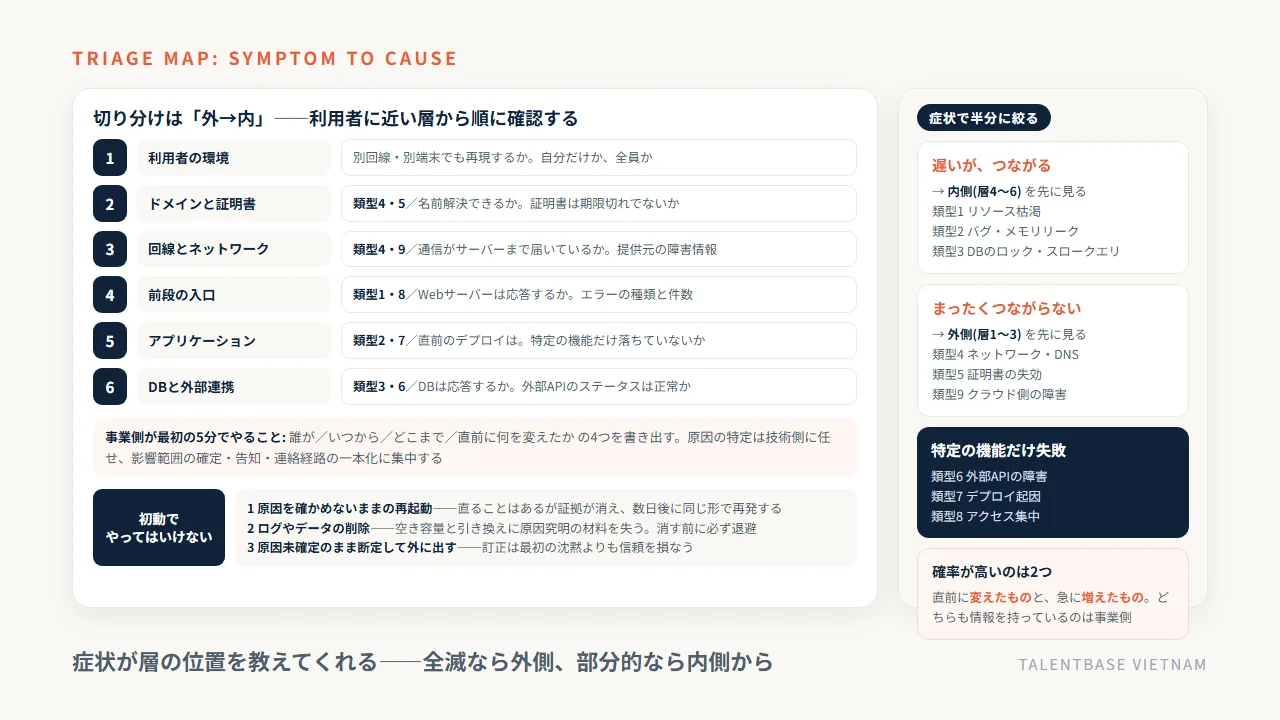
切り分けは「外→内」の順番で見る——利用者の経路からアプリの中へ
原因の切り分けには、決まった順番があります。利用者に近い外側から、システムの内側へ向かって順に確認していく方法です。順番が決まっているので、技術者でなくても「いまどこまで確認が終わっているか」を追えます。
- 利用者の環境——特定の人だけか。別の回線・別の端末でも起きるか
- ドメインと証明書——名前解決はできるか。証明書の有効期限は切れていないか
- 回線とネットワーク——通信はサーバーまで届いているか
- 前段の入口——Webサーバーやロードバランサーは応答しているか。エラーの種類は何か
- アプリケーション——処理は動いているか。特定の機能だけ落ちていないか
- データベースと外部連携——データベースは応答しているか。外部APIは正常か
外側の層で止まっていれば全ユーザーが一様に影響を受け、内側の層なら「一部の機能だけ」「一部の操作だけ」という形になります。最初に確かめた「誰が・どこまで」が、この順番のどこを最初に見るかを決めてくれます。委託先への連絡も「落ちました、見てください」ではなく、「全ユーザーが全機能にアクセスできません。1から3の層から確認をお願いします」と言えるだけで、初動が変わります。
非エンジニアでもできる確認3つ——別回線・提供元のステータス・直前のデプロイ
技術者を待たずに、事業側だけでできる確認が3つあります。
1つ目は、別の回線と別の端末から試すことです。社内のWi-Fiではなくスマートフォンの回線で、いつもと違うブラウザで開いてみます。自分だけ見えていないのか、全員なのかがこれで分かります。社内からだけ見えない場合は、自社ネットワーク側の問題である可能性が出てきます。
2つ目は、クラウド提供元と外部サービスの障害情報を見ることです。AWS、Google Cloud、Microsoft Azure は、それぞれ稼働状況を公開するページを持っています。決済代行、メール配信、認証サービスなども同様です。ここに障害が出ていれば、自社側で直せる問題ではないと分かり、告知の書き方も変わります。
3つ目は、直前24時間にデプロイ(本番反映)があったかを確認することです。リリース直後の障害は、まず切り戻しを検討します。デプロイと切り戻しの仕組みそのものは「デプロイとは」の記事で詳しく整理しているので、社内で用語が揃っていない場合はそちらを共有してください。
やってはいけない3つ——闇雲な再起動、ログの削除、原因未確定の断定
最後に、初動でやってはいけないことを3つ挙げます。いずれも「よかれと思って」やってしまいがちなものです。
1つ目は、原因を確かめないままの再起動です。再起動すると直ることはありますが、同時に、メモリ上の状態やプロセスの情報という証拠が消えます。原因が分からないまま復旧し、数日後に同じ形で再発する。これが最も多い失敗のパターンです。再起動する場合も、その前に「いつ・誰が・何を再起動したか」を記録してください。
2つ目は、ログやデータの削除です。「ディスクがいっぱいだからログを消す」という対応は、空き容量を作ると同時に、原因究明の材料を消します。攻撃の可能性がある場合はなおさらで、証跡を壊すと被害範囲すら確定できなくなります。消す前に必ず退避してください。
3つ目は、原因が確定していないのに断定して外に出すことです。「アクセス集中が原因です」と第1報で書いてしまい、後から設定ミスだったと判明する。訂正のほうが、最初の沈黙よりもはるかに信頼を損ないます。要注意です。では、症状から原因をどう絞り込むのか。次章で9つの類型に整理します。
サーバー障害の原因9類型——症状から「最初に見る場所」を決める対応表
障害の原因は無数にあるように見えますが、事業会社が自社サービスで遭遇するものは9つの類型にまとまります。大切なのは原因を暗記することではなく、「いま出ている症状から、どの類型を先に疑うか」を決められることです。まずは一覧で全体像を押さえてください。表の見方は、左から右へ「症状 → 疑う原因 → 最初に見る場所 → 一次対応」の順です。
原因9類型の対応表(症状・典型的な原因・最初に見る場所・一次対応)
No | 原因の類型 | よくある症状 | 最初に見る場所 | 一次対応 |
|---|---|---|---|---|
1 | リソースの枯渇(CPU・メモリ・ディスク・接続数) | 全体が重い。時間とともに悪化。書き込みだけ失敗する | サーバーのCPU・メモリ・ディスク使用率、同時接続数の上限設定 | 不要なプロセスの停止、ディスクの空け(ログは退避してから)、一時的な増強 |
2 | アプリのバグとメモリリーク | 起動直後は正常で、数時間〜数日で重くなる。再起動で一度直る | エラーログ、直近のリリース内容、メモリ使用量の推移 | 該当機能の一時停止、切り戻し、暫定的な定期再起動 |
3 | データベースのロックとスロークエリ | 特定の操作だけ固まる。一覧や検索が異常に遅い。タイムアウトが出る | データベースの実行中クエリ、待ち状態、スロークエリログ | 長時間実行のクエリを止める、該当機能の一時停止、索引の追加は恒久対応で |
4 | ネットワークとDNS | 全ユーザーが「つながらない」。名前解決に失敗する。特定の回線からだけ届かない | ドメインの設定と有効期限、名前解決の結果、回線事業者の障害情報 | 設定の切り戻し、上位の障害情報の確認、代替経路の案内 |
5 | サーバー証明書の失効・期限切れ | ブラウザが警告を出す。アプリからの通信だけ失敗する。ある日時を境に一斉に起きる | 証明書の有効期限、自動更新の仕組みが動いているか | 証明書の再発行と反映。更新の自動化を恒久対応に入れる |
6 | 外部APIの障害(決済・認証・地図・生成AIなど) | 特定の機能だけ失敗する。自社の画面は開く | 外部サービスのステータスページ、連携部分のエラーログ | 該当機能の停止と告知、タイムアウトとリトライの見直し |
7 | デプロイ起因(リリース・設定変更) | リリース直後に発生。特定の画面だけエラー。環境によって挙動が違う | 直近のデプロイ履歴、変更差分、設定ファイル | まず切り戻し。原因調査は戻してから |
8 | アクセス集中(キャンペーン・報道・攻撃) | 短時間で急に重くなる。一部のリクエストだけ失敗する | アクセス数の推移、送信元の偏り、キャンペーンの開始時刻 | 一時的な増強、順番待ち画面への切り替え、不審な送信元の遮断 |
9 | クラウド・データセンター側の障害 | 自社で何も変えていないのに落ちる。同じ地域の他社サービスも落ちている | クラウド提供元のステータスページ、影響を受けている地域 | 復旧を待ちつつ告知。多地域構成なら切り替え |
サイバー攻撃は、表のNo.8とNo.9の姿で現れることが多い原因です。ただし攻撃への備えは障害対応とは別の設計が要るので、本記事では扱いません。委託先との取り決めや対策の層については「オフショア開発のセキュリティ対策」の記事にまとめています。
「遅い」と「つながらない」で疑う場所が変わる——リソース枯渇・スロークエリと、DNS・証明書
9類型を全部覚える必要はありません。症状を2つに分けるだけで、見る場所は半分に絞れます。
「遅いが、つながる」場合は、内側の層を疑います。リソースの枯渇(No.1)、メモリリーク(No.2)、データベースのスロークエリ(No.3)が候補です。これらは負荷が増えるほど悪化し、時間とともに進行します。「朝は速かったが夕方に重い」「特定の一覧画面だけ固まる」といった偏りがあれば、データベース側の可能性が高くなります。
「まったくつながらない」場合は、外側の層を疑います。DNS(No.4)、証明書(No.5)、クラウド側の障害(No.9)です。これらは全ユーザーが一斉に、同じ時刻から影響を受けるのが特徴です。とくに証明書の失効は「ある日時を境に、昨日まで動いていたものが突然止まる」という分かりやすい形で出ます。
証明書は、これから障害原因として増える側の項目です。SSL/TLSサーバー証明書の最大有効期間は、CA/Browser Forum の投票 SC-081v3 により、2026年3月から2029年3月にかけて398日から47日へ段階的に短縮されることが決まっています(2026-09-15確認)。加えて Let's Encrypt は、有効期限を知らせるメールの送信を2025年6月4日で終了しました。更新の頻度は上がり、人が気づくきっかけは減る。自動更新が本当に動いているかを、平時に一度確かめてください。
変更と負荷を先に疑う——デプロイ起因とアクセス集中は、増え方の形が違う
原因の当たりをつけるとき、確率が高いのは「直前に変えたもの」と「急に増えたもの」の2つです。どちらも事業側が情報を持っています。
デプロイ起因(No.7)は、時刻が一致するのが特徴です。リリースの完了時刻とエラーの立ち上がりが重なっていれば、ほぼ確定と考えてよいでしょう。この場合、原因調査より先に切り戻しを検討します。「原因を突き止めてから直す」より「戻してから調べる」ほうが、事業の損害は小さくなります。
アクセス集中(No.8)は、増え方の形で見分けます。キャンペーンやテレビ紹介による集中は、開始時刻から数分で立ち上がり、なだらかに減っていきます。一方、攻撃は送信元が偏り、特定の経路に集中し、ユーザーの行動として不自然な形を描きます。どちらかを判断するには、アクセス数の推移と送信元の分布を見るしかありません。そのため、後述する監視でこの2つを平時から取っておくことが効いてきます。
自社では直せない原因——クラウド側の障害と外部APIの停止、SLAの読み方
9類型のうち、No.6とNo.9は自社で直せません。できるのは、影響範囲を確定し、告知を出し、復旧を待つことだけです。
「クラウドなら落ちない」という前提は成り立ちません。AWS は2025年10月19日から20日にかけて、米国東部リージョンで大規模な障害を起こしました。公式の障害レポートは、DynamoDB のDNS管理システムに潜在していた競合状態(レースコンディション)によって、リージョンのエンドポイントのDNSレコードが空になったことを根本原因として説明しています。同レポートによれば、DynamoDB 自体の復旧までに約3時間、EC2 の新規インスタンス起動が完全に復旧するまでには約14時間を要しました。世界最大級の事業者でも、この規模の停止は起こります。
提供元も可用性を100%とは約束していません。AWS の Amazon Compute SLA は、Amazon EC2 について、複数のアベイラビリティゾーンを使うリージョン単位の構成で月間稼働率99.99%以上、単一インスタンスでは99.5%以上をコミットメントとしています(2026-09-15確認)。Google Cloud の Compute Engine SLA は、Premium Tier の主要リージョンで複数ゾーンにまたがるインスタンスが99.99%以上、単一インスタンスは種類に応じて99.9%または99.95%以上です(同日確認)。Microsoft は、可用性セットに2台以上の仮想マシンを配置することを99.95%のSLAの条件として案内しています。つまり、1台構成で動かしている限り、どのクラウドでも高い可用性は約束されていないのが実情です。この数字が実際に何分にあたるかは、後半の検算表で確かめます。
一次対応の順番と、ユーザーへの告知の出し方
復旧作業と、ユーザーへの説明は別の仕事です。同じ人がどちらもやろうとすると、両方が遅れます。ここでは技術側が進める一次対応の順番と、事業側が担う告知の出し方を分けて整理します。告知は「原因が分かってから」ではなく、分からないうちから出すものだという点だけ、先に押さえてください。
一次対応の5ステップ——止血、切り戻し、縮退、復旧判定、記録
一次対応の目的は、原因の解明ではなく被害を止めることです。順番は次の5つです。
- 止血——被害が広がるのを止めます。エラーを返し続ける機能を止める、順番待ち画面に切り替える、書き込みを一時的に止めてデータの破損を防ぐ。この段階では、直すことより広げないことを優先します
- 切り戻し——直前にデプロイや設定変更があれば、まず元に戻します。戻して直れば原因はそこにあり、戻して直らなければ別の原因だと分かります。調査としても最短です
- 縮退運転——全機能の復旧に時間がかかるなら、一部を止めて残りを生かします。「決済だけ止めて閲覧は使える」状態は、全停止よりはるかに損害が小さい。どの機能を切り離せるかは平時に決めておきます
- 復旧判定——「動いたように見える」で終わらせず、基準で判定します。エラー率が通常値に戻ったか、応答時間が戻ったか、外形監視が連続して成功しているか。感覚で復旧宣言を出して再発すると、2回目の告知が最も信頼を損ないます
- 記録——何時に誰が何をしたかを、その場で書き残します。後から思い出して書くと必ず抜けます。この記録が、翌週の振り返りと再発防止の材料になります
事業側が関わるのは、主に1と3と4です。「どの機能を止めてよいか」「どの状態なら復旧と言ってよいか」は事業判断であって、技術判断ではありません。ここを委託先に投げてしまうと、判断待ちで時間が溶けます。
告知は3回に分けて出す——第1報・続報・復旧報の型
告知は1回ではなく3回です。原因が分かるまで黙っているのが最も損をします。
回 | 出すタイミング | 書くこと | 書かないこと |
|---|---|---|---|
第1報 | 障害を認識してから15〜30分以内 | 事象、影響範囲、開始時刻、調査中であること、次の報告予定時刻 | 原因の推測、復旧時刻の確約 |
続報 | 第1報で宣言した時刻に必ず出す(進展がなくても出す) | 現在の状況、分かったこと、回避策があれば案内、次の報告予定時刻 | 未確定の原因、責任の所在 |
復旧報 | 復旧判定の基準を満たしたあと | 復旧時刻、影響した範囲と期間、利用者にお願いすること(再ログインなど)、原因と再発防止は後日報告する旨 | 詳細な技術原因(別途、報告書で) |
いちばん守れないのは「次の報告予定時刻に、進展がなくても出す」という約束です。調査が進んでいないと出しにくくなりますが、「まだ原因を特定できていません。次は15時に報告します」の一行があるかないかで、受け手の不安はまったく変わります。沈黙は、悪い知らせより悪く受け取られるのが実情です。
告知文に入れる7要素——書いてよいことと、書いてはいけないこと
告知文はテンプレートを平時に作っておき、当日は穴埋めにします。入れるべき要素は7つです。
No | 要素 | 書き方の例 |
|---|---|---|
1 | 何が起きているか | 「一部のお客様において、ログインができない事象が発生しております」 |
2 | いつから | 「9月15日 9時10分ごろより」 |
3 | 誰に影響しているか | 「すべてのお客様/管理画面をご利用のお客様に限り」 |
4 | 何ができて、何ができないか | 「閲覧は可能ですが、新規のお申し込みができない状態です」 |
5 | 回避策 | 「お手数ですが、時間をおいて再度お試しください」 |
6 | 次の連絡予定 | 「11時をめどに、続報をお知らせいたします」 |
7 | 問い合わせ先 | 「本件に関するお問い合わせは〇〇まで」 |
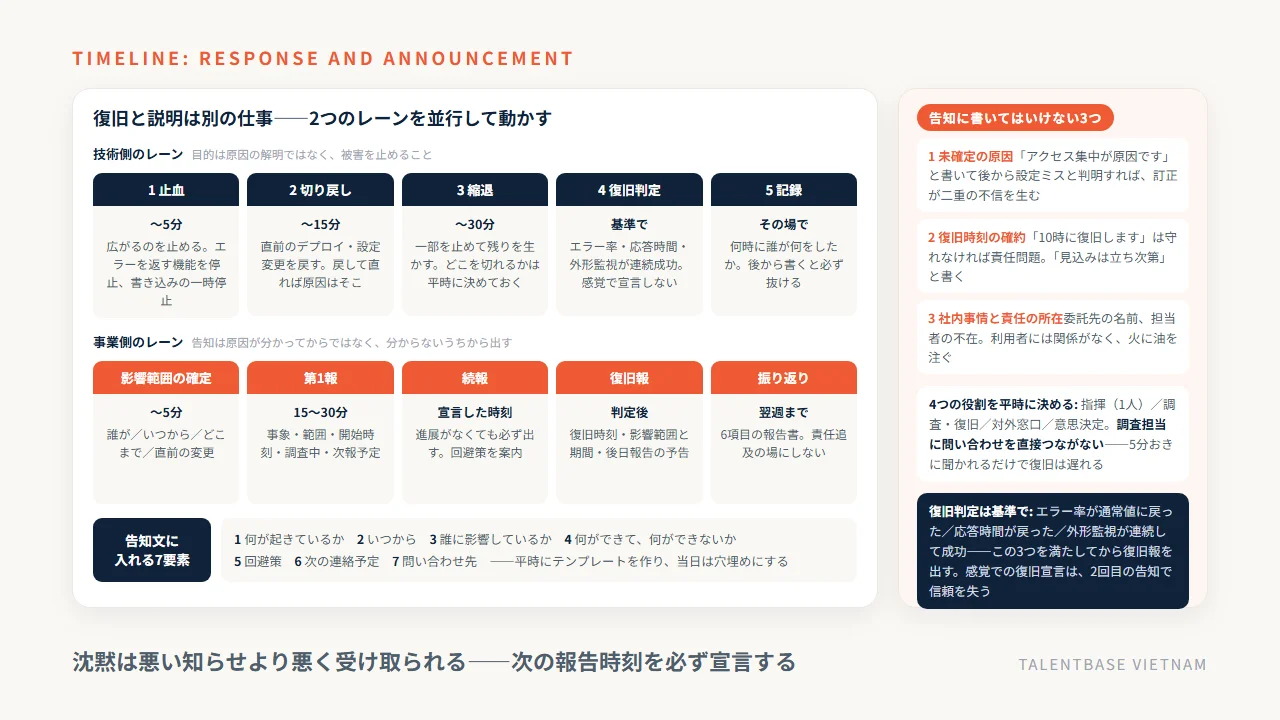
逆に、書いてはいけないものが3つあります。1つ目は未確定の原因です。「アクセス集中によるものです」と書いて後から設定ミスだったと判明すれば、訂正が二重の不信を生みます。2つ目は復旧時刻の確約です。「10時には復旧します」は守れなければ責任問題になります。書くなら「復旧の見込みは立ち次第お知らせします」です。3つ目は社内事情と責任の所在です。委託先の名前や「担当者が不在で」といった説明は、利用者には関係がなく、火に油を注ぎます。
社内の連絡経路と4つの役割——指揮、調査・復旧、対外窓口、意思決定
障害の最中に最も時間を奪うのは、技術的な調査ではなく「誰が決めるのか分からない」状態です。役割を4つに分け、平時に名前を入れておいてください。
- 指揮——全体の進行を握り、次に何をするかを決める。復旧作業には手を出さない。1人だけ置く
- 調査・復旧——実際に原因を追い、手を動かす。ここに問い合わせを流し込まない
- 対外窓口——告知とカスタマーサポート、必要なら取引先への連絡。調査担当と分ける
- 意思決定——サービスの停止、返金、公表範囲といった経営判断を行う
とくに大事なのは、調査担当に問い合わせを直接つながないことです。復旧を進めている人が5分おきに「まだですか」と聞かれると、単純に復旧が遅れます。窓口を一本化して、指揮役が定時に状況をまとめて流す。この形にするだけで、体感の混乱はかなり減ります。では、復旧したあとは何をすればよいのでしょうか。
復旧後の原因究明と再発防止——監視とアラートの最低限
復旧した翌日が、いちばん手を抜きたくなるタイミングです。全員が疲れていて、通常業務も溜まっている。しかしここで振り返りを省くと、同じ障害が同じ形で再発します。ここでは、委託先に何を出してもらうべきか、再発防止として何を求めるのが妥当か、監視はどこから始めればよいかを整理します。
振り返りで書く6項目——「アクセス集中でした」は原因ではない
復旧後の報告書に何が書かれていれば合格か。基準を持っていないと、「一時的なアクセス集中と考えられます」の一行で終わってしまいます。これは原因ではなく症状です。なぜその負荷に耐えられなかったのかが書かれて、はじめて原因究明になります。求める項目は6つです。
No | 項目 | 何が書かれていれば十分か |
|---|---|---|
1 | 時系列 | 発生・検知・一次対応・復旧の各時刻。誰が何をしたか |
2 | 影響 | 影響を受けた機能、ユーザー数または件数、停止していた時間 |
3 | 直接の原因 | 何がどうなって止まったか。設定値や処理の名前まで具体的に |
4 | 背景の原因 | なぜそれが起きえたのか。レビューを通ったのか、上限値は誰がいつ決めたのか |
5 | 検知と拡大の経緯 | なぜすぐ気づけなかったのか。なぜ影響が広がったのか |
6 | 再発防止と期限 | 何を、誰が、いつまでにやるか。やらないと決めたことも理由つきで |
5番目の「なぜすぐ気づけなかったのか」を必ず入れてください。原因を直しても、次の別の障害には別の原因があります。しかし検知が遅い体質は、すべての障害で効いてきます。そして振り返りは、責任追及の場にしないことです。担当者を責める場だと分かった瞬間、翌年から正確な情報は出てこなくなります。
再発防止は3方向で考える——早く気づく、影響を狭める、戻せるようにする
再発防止策を「もっと気をつける」で終わらせないために、3つの方向に分けて考えます。委託先から出てきた対策案が、どれにあたるかを確かめてください。
- 早く気づく——監視の追加、しきい値の見直し、通知経路の整備。原因が何であれ、検知が10分早まれば被害も減ります
- 影響を狭める——1か所の不調が全体を巻き込まない形にする。外部APIが遅いときに自社まで止まらないようにタイムアウトを切る、機能ごとに切り離せるようにする、前段で負荷を受け止める
- 戻せるようにする——切り戻しの手順を決めておく、バックアップからの復元を実際に試しておく。バックアップは「取れていること」ではなく「戻せること」を年に1〜2回確認しないと、いざというときに使えません
この3方向のうち、費用対効果がいちばん高いのは1です。監視は数万円規模から始められ、効果がすべての障害に及びます。逆に、いきなり冗長化や多地域構成の話から入ると、費用が跳ね上がって何も進まないまま終わります。順番を間違えないでください。
監視の最低限5つ——外形監視、エラー率、応答時間、リソース、期限切れ
監視は項目を増やすほどよいわけではありません。運用しきれない監視は、結局見なくなります。まずは次の5つから始めれば十分です。
No | 監視項目 | 何を見るか | なぜ必要か |
|---|---|---|---|
1 | 外形監視 | 外部から実際にページやAPIを叩き、応答が返るか | ユーザーと同じ目線で見る唯一の指標。サーバーが生きていても使えない状態を検知できる |
2 | エラー率 | エラー応答の割合。通常時との比 | 「全滅」ではない部分的な障害を早く捉えられる |
3 | 応答時間 | 主要な画面・APIの所要時間 | 止まる前の予兆が出る。遅延は障害の前段階 |
4 | リソース | CPU・メモリ・ディスク使用率、接続数 | 枯渇系の原因(類型1)を事前に潰せる |
5 | 期限切れ | 証明書の有効期限、ドメインの更新期限、外部サービスの鍵の期限 | 予告なく全停止する原因のうち、唯一100%予防できる項目 |
5番目の期限監視は、費用がほぼゼロで効果が確実な項目です。証明書の有効期間短縮が進む以上、ここは必ず自動で見張ってください。当社では、リリース前のダブルチェックとあわせて期限の確認を運用の型に入れています。
アラートは「人を起こす基準」で設計する——鳴りすぎるアラートは鳴らないのと同じ
監視を入れたあとに必ず起きるのが、アラートが鳴りすぎて誰も見なくなる問題です。1日に50件届く通知は、0件と同じ意味しか持ちません。設計の原則は3つです。
1つ目は、通知を2段階に分けることです。「すぐ人を呼ぶもの」と「翌営業日に見ればよいもの」を分け、前者は数を絞ります。目安として、深夜に人を起こす条件は「利用者が使えない」に相当するものだけにします。
2つ目は、一時的な揺れで鳴らさないことです。1分の遅延ではなく「5分間続いたら」という条件にする。これだけで通知の数は大きく減ります。
3つ目は、通知に次の行動を添えることです。「CPU使用率90%」だけでは、受け取った人は何もできません。「該当サーバー」「確認する手順の場所」「連絡する相手」までを通知に含めておくと、夜中に起きた人がそのまま動けます。
監視とアラートを整えると、障害は「ユーザーからの問い合わせで気づく」ものから「こちらが先に気づいて告知する」ものに変わります。この差は、事業の信頼という意味では復旧時間の差より大きい。では、これを誰が見張るのか。委託先との契約で決めておくべきことを、次章で整理します。
保守契約で決めておく6項目と、外部チームで運用を持つときの体制(当社の場合)
障害の最中に契約書を読み始めることほど、つらい時間はありません。「障害時は誠実に対応する」としか書かれていない契約は、実質的に何も決めていないのと同じです。ここでは、委託先との契約で必ず言葉にしておく6項目と、外部チームで保守運用を持つときの体制の考え方を整理します。費用相場と頼み先の比較は「システム改修・開発保守の外注」の記事に、開発会社そのものの選び方は「システム開発会社の選び方」の記事にまとめているので、本章は取り決めの中身だけを扱います。
決めておく6項目(受付時間、一次対応の定義、復旧目標、連絡経路、エスカレーション、記録)
No | 決めること | 具体的に書く内容 | 決めていないと起きること |
|---|---|---|---|
1 | 受付時間 | 平日何時から何時まで。時間外の扱い。土日祝と年末年始。海外チームなら現地の祝日も | 夜間に連絡がつかず、翌朝まで放置される |
2 | 一次対応の定義 | 「一次対応」として何をするか。連絡を受けるだけか、状況確認までか、復旧作業まで含むか | 「対応します」の中身が食い違い、復旧が始まらない |
3 | 復旧目標 | 何分以内に着手するか(応答目標)。どの状態を復旧とみなすか。障害の重大度ごとの区分 | 着手が何時間後でも契約違反にならない |
4 | 連絡経路 | 一次連絡先、その不在時の連絡先、使う手段(電話・チャット・チケット)。自社側の窓口も1人に決める | 全員が別々に連絡し、誰も全体を把握していない状態になる |
5 | エスカレーション | どの条件で誰に上げるか。全停止、データの不整合、攻撃の疑いは即時に経営層へ | 判断できる人に情報が届かないまま時間が過ぎる |
6 | 記録と報告 | 障害ごとに何を記録し、いつまでに報告書を出すか。振り返りの場を持つか | 「アクセス集中でした」で終わり、同じ障害が繰り返される |
このうち最も食い違いが起きるのが2の「一次対応の定義」です。発注側は復旧作業まで含むと思い、受注側は状況の確認と報告までのつもりでいる。契約前に「深夜1時に決済が止まったら、御社は何をしてくれますか」と具体的な場面で聞いてください。答えられない会社とは、その部分を書き足してから契約します。
稼働率の数字は「年間何分止まってよいか」に直して読む——検算表
SLAや提案書に出てくる稼働率は、そのままでは大きさが分かりません。時間に直すと判断できます。1年を365日(525,600分)、1か月を30日(43,200分)として計算すると次のとおりです。
稼働率 | 1か月に止まってよい時間 | 1年に止まってよい時間 |
|---|---|---|
99.0% | 432分(7時間12分) | 5,256分(87時間36分) |
99.5% | 216分(3時間36分) | 2,628分(43時間48分) |
99.9% | 43.2分 | 525.6分(約8時間46分) |
99.95% | 21.6分 | 262.8分(約4時間23分) |
99.99% | 4.32分 | 52.56分(約52分) |
この表を持って自社の要件を考えると、議論が具体的になります。「年8時間46分まで止まってよいなら99.9%でいい」「決済が年43時間止まるのは無理だから99.5%では足りない」。逆に、99.99%を求めるなら月4分での復旧が前提になり、人の手による復旧では間に合いません。自動での切り替えが要る、つまり構成の費用が跳ね上がるということです。
なお、クラウド提供元のSLAは自社サービスの稼働率とは別物です。AWS の Amazon Compute SLA は Amazon EC2 について、リージョン単位で99.99%以上、単一インスタンスで99.5%以上をコミットメントとしています(2026-09-15確認)。Google Cloud の Compute Engine SLA も、Premium Tier の主要リージョンで複数ゾーン構成が99.99%以上、単一インスタンスは99.9%または99.95%以上です(同日確認)。下回った場合の救済は返金ではなく将来の請求へのクレジットで、AWS は10%・30%・100%、Google Cloud は10%・25%・100%の3段階です。停止による売上の損失が補填されるわけではない、という点は押さえておいてください。
当社の体制——週次保守、時差2時間で日本の営業時間と重なる。24時間365日は持たない
当社は、日本人PMまたはブリッジSEをフロントに置いたベトナムの専属チームで、開発だけでなくリリース後の保守運用も担当しています。たとえば決済アプリの案件では、Stripe を使った決済、二要素認証、ウォレット、帳票のPDF出力までを新規開発し、リリース後は週次の保守運用へ移行しました。介護記録SaaS「CareViewer」では、日本語のブリッジSE1名とフルスタックエンジニア2名の体制で、週次の優先順位の判断を挟みながら継続的に開発と改善を進めています。品質は人ではなく仕組みで担保する方針で、日本人PMによる設計レビュー、Gitのプルリクエストによるコードレビューの標準化、リリース前のダブルチェックを型にしています。インフラ面ではAWS認定11冠のメンバーが在籍しています。
体制面で相性がよいのは、時差です。ベトナムと日本の時差は2時間で、ホーチミンの営業時間は日本の営業時間とほぼ重なります。日本の午前中に起きた障害に、現地チームが同じ午前中のうちに動けるということです(詳しくは「ベトナムと日本の時差」の記事)。契約と支払いは日本国内法人・日本法準拠で、海外送金は不要です。
一方で、率直に書きます。当社は24時間365日のオンコール体制を標準では提供していません。深夜・早朝に人を起こして即時復旧することが事業要件なら、その体制を持つ運用専門の会社を選ぶべきです。当社が担えるのは、日本とほぼ同じ営業時間帯での保守運用、監視の設計と設定、障害後の原因究明と再発防止の作り込み、そして継続的な改修です。なお、ベトナムの祝日は2026年で年12日(労働法112条の法定は11日で、2026年からベトナム文化の日が加わります)で、2026年のテト(旧正月)は2月14日から22日にあたります。この期間の対応体制は契約時に決めておく必要があります。
向く案件・向かない案件
向く案件は、日中の障害対応で足りるサービス、リリース後も改修が続くプロダクト、監視や運用の型そのものを一緒に作りたい案件です。1名から始められ、最短2週間で開始でき、増員は約1週間、縮小や交代は1か月単位で調整できます。最小構成は日本人PMのフロント付きで2〜3人月、月額約80万円からです。
向かない案件は、深夜・早朝の即時復旧が契約要件になっているサービス、医療や金融など停止が直ちに人命や資産に及ぶ領域、そして自社側に判断できる担当を一切置けない体制です。3つ目は当社に限らず、外部委託そのものが成立しません。合わないと判断した場合は、その旨を率直にお伝えしています。
サーバー障害の原因と対応に関するよくある質問
最後に、サーバー障害の原因と対応について、事業会社の担当者からよく受ける質問を5つまとめます。いずれも本文で触れた内容の要点ですが、社内で説明するときにそのまま使える形にしました。
Q1. 原因が分からないまま復旧してしまいましたが、このまま様子を見てよいですか
よくありません。原因が分からないまま直った障害は、同じ形で再発します。最低限、発生から復旧までの時系列、影響した範囲と時間、そのとき何を変えたかを記録に残し、委託先に「なぜ起きえたのか」と「なぜすぐ検知できなかったのか」の2点を出してもらってください。再現しない障害でも、検知を速くする対策は必ず打てます。
Q2. ユーザーへの告知は、原因が特定できてから出すべきですか
逆です。障害を認識してから15〜30分以内に第1報を出してください。第1報に原因は不要で、事象・影響範囲・開始時刻・調査中であること・次の報告予定時刻の5つがあれば足ります。原因を推測で書くほうが危険で、後から訂正することになれば、沈黙よりも信頼を損ないます。
Q3. 提案書に「稼働率99.9%」とありました。これは十分な水準ですか
サービスの性質によります。99.9%は、1か月(30日)あたり43.2分、1年あたり約8時間46分まで止まってよいという意味です。社内向けの業務システムなら十分な水準ですが、決済や予約のように停止が直ちに売上と信頼に響くサービスでは物足りないと感じるはずです。99.99%(1か月あたり4.32分)を求めるなら、人の手による復旧では間に合わず、自動で切り替わる構成が前提になり、費用は大きく変わります。
Q4. 監視は何から始めればよいですか。予算が限られています
外部から実際にサービスを叩いて応答を確認する外形監視と、証明書やドメインの期限監視の2つから始めてください。この2つは費用が小さく、効果が確実です。外形監視は「サーバーは生きているのにユーザーは使えない」状態を唯一捉えられる指標で、期限監視は予告なく全停止する原因のうち、完全に予防できる数少ない項目です。余裕が出たらエラー率、応答時間、リソース使用率を足していきます。
Q5. クラウド側の障害で自社サービスが止まった場合、責任は誰にありますか
利用者に対する責任は、自社にあります。クラウド提供元のSLAは提供元と自社の間の取り決めで、下回った場合の救済も返金ではなく将来の請求へのクレジットです。売上の損失は補填されません。AWS は2025年10月19日から20日にかけて米国東部リージョンで大規模な障害を起こし、公式レポートでDNS管理システムの競合状態を根本原因と説明しています。クラウドを使っていても止まるという前提で、影響を狭める設計と、止まったときの告知の型を自社で持っておくこと。
まとめ: 原因を当てる前に影響範囲を確定する——切り分けは外から内へ、告知は3回、復旧後は監視と契約に落とす
サーバー障害が起きたとき、事業側の担当者が最初の5分でやるべきことは、原因を当てることではありません。誰が・いつから・どこまで影響を受けているかを確定し、直前に何を変えたかを洗い出し、連絡経路を一本化する。この3つです。切り分けには「利用者の環境 → ドメインと証明書 → 回線 → 前段 → アプリ → データベースと外部連携」という決まった順番があり、順番を持っていれば技術者でなくても委託先に何を頼めばよいかが分かります。原因は9類型に整理でき、「遅い」なら内側、「つながらない」なら外側を先に疑います。
告知は原因が分かってから出すものではありません。認識から15〜30分で第1報、宣言した時刻に続報、基準を満たしてから復旧報の3回に分けます。復旧後は「アクセス集中でした」で終わらせず、なぜ耐えられなかったのか、なぜすぐ検知できなかったのかまで出してもらう。再発防止は、早く気づく・影響を狭める・戻せるようにするの3方向で考え、監視は外形監視と期限監視の2つから始めれば十分です。そして保守契約では、受付時間、一次対応の定義、復旧目標、連絡経路、エスカレーション、記録の6項目を言葉にしておく。稼働率は「年間何分止まってよいか」に直すと、社内の合意が一気に取りやすくなります。
当社は日本人PMをフロントに置いたベトナムの専属チームで、新規開発だけでなくリリース後の週次保守まで担当しています。時差は2時間で、ホーチミンの営業時間は日本の営業時間とほぼ重なります。ただし24時間365日のオンコール体制は標準では持っていません。深夜の即時復旧が事業要件なら、その体制を持つ会社を選ぶべきです。保守や改修の費用相場と頼み先の比較はシステム改修・開発保守の外注、委託先そのものの見極め方はシステム開発会社の選び方もあわせてご覧ください。現在の体制と要件をお聞かせいただければ、保守運用を外部チームで持つ場合の体制と概算見積もりでお答えします。合わない案件にはその旨も率直にお伝えします。