「AWSのElasticsearchを使いたいのですが、コンソールを開くと名前が違うんです」——ここ数年、こうした相談をよく受けます。設計書や過去の記事には Amazon Elasticsearch Service と書いてあるのに、AWSの画面には Amazon OpenSearch Service と表示される。同じものなのか、別のものなのか、判断がつかないという状態です。
結論から言えば、AWSのマネージドサービスは2021年9月8日に Amazon Elasticsearch Service から Amazon OpenSearch Service へ改名されました。そして同じ時期に、ソフトウェア本体も Elastic社の Elasticsearch と、AWSが分岐させた OpenSearch の2系統に分かれています。きっかけはライセンスの変更で、この変更は2021年だけでなく2024年にもう一度動いています。つまり、古い記事を読んで設計すると、名前だけでなくバージョンとサポート期限の前提まで古いまま進むことになります。
ただ、名前の答え合わせが済んだあとに本当に決めなければならないのは、別のことです。そもそも全文検索エンジンが自社に必要なのか。必要だとして、毎月いくら払い続けることになるのか。検索エンジンは導入して終わりの部品ではなく、インスタンスが動いている限り課金が続き、日本語で使う場合は辞書の手入れも運用として続きます。ここを見落とした結果、想定の数倍の請求が続いている環境を見かけます。
この記事では、名称とライセンスの整理から始めて、データベースのLIKE検索で足りなくなる境界、日本語の全文検索が難しい理由、マネージドで使うときに決める4つ、料金が膨らむ要因、そして代替の選択肢までを、発注・投資判断ができる粒度で整理します。設定ファイルの書き方やコードは一切扱いません。名称変更とライセンスの経緯はAWS公式ブログ・AWS公式ドキュメント・Elastic社の公式発表・Linux Foundationの公式発表で、料金はAWSが公開している価格データで確認しました(いずれも2026年9月19日時点)。
筆者は人材業界出身で、2018年からベトナム・ホーチミンに住み、これまで約100社の開発体制づくりを支援してきました。検索基盤のように「作って終わりにならない領域」を外部チームで持つ場合、何を先に決めておくべきかは、体制の設計そのものに関わります。最後の章では、その観点から確認すべき点をまとめます。
目次
- 「AWSのElasticsearch」は2021年9月8日で名前が変わっている
- 2021年に何が起きたか
- ライセンスの現在地
- 改名で変わったもの・変わらなかったもの
- そもそも全文検索エンジンが要るのか
- LIKE検索の3つの限界
- インデックスという考え方
- 入れなくてよい場合と、入れたほうがよい場合の境界
- 日本語の全文検索が難しい理由
- 日本語には単語の区切りがない
- 形態素解析とN-gram
- 辞書の手入れは運用として続く
- Amazon OpenSearch Service で決める4つ
- デプロイ方式
- インスタンス構成とシャード
- 可用性ゾーンと専用マスターノード
- アクセス制御
- 料金はどこで膨らむか
- 東京リージョンの公開単価
- 膨らむ3つの方向
- 代替の選択肢1: データベースの全文検索機能で足りないか
- 代替の選択肢2: 検索SaaS(Algolia等)に外に出す
- 検索基盤を含むシステムを外部チームで作る・運用するときの体制
- 検索基盤は「作って終わり」にならない
- 外部チームに任せるとき、発注側が確認する4点
- 当社の担い方
- 【FAQ】AWSのElasticsearch(Amazon OpenSearch Service)に関するよくある質問
- Q1. 結局、いまAWSで全文検索エンジンを使うと何を選ぶことになりますか
- Q2. 既存のElasticsearch 7.10はいつまで使えますか
- Q3. Elastic社のElasticsearch(8系・9系)をAWSで使えますか
- Q4. 日本語検索で、最初に決めることは何ですか
- Q5. 小さく試すといくらかかりますか
- まとめ: 「AWSのElasticsearch」は Amazon OpenSearch Service
「AWSのElasticsearch」は2021年9月8日で名前が変わっている——Amazon OpenSearch Serviceと、3つの名前の関係
まず名前を確定させます。AWSで全文検索エンジンをマネージドで使うとき、いま契約するサービスの名前は Amazon OpenSearch Service です。Amazon Elasticsearch Service という名前は、AWSが2021年9月8日に公式ブログで改名を発表して以降、新規に使われていません。ただし、サービスが消えたわけでも、中身が別物に入れ替わったわけでもありません。起きたのは「サービスの名前が変わったこと」と「その上で動かせるソフトウェアが2系統に分かれたこと」の2つで、この2つを分けて理解すると混乱が解けます。
2021年に何が起きたか——ライセンス変更から改名までの時系列
発端はライセンスです。Elastic社は2021年1月14日の公式ブログで、Elasticsearch と Kibana の Apache License 2.0 のコードを、SSPL(Server Side Public License)と Elastic License のデュアルライセンスへ変更すると発表しました(https://www.elastic.co/blog/licensing-change)。適用は当時の次期リリースである 7.11 の前とされています。同社は理由として、クラウド事業者が自社のオープンソース製品をサービスとして提供しながら還元していないこと、商標の誤用や分裂の試みがあったことを挙げています。
AWSはこれを受けて、最後の Apache 2.0 版である Elasticsearch 7.10.2 と Kibana 7.10.2 から分岐(フォーク)した OpenSearch を開発し、2021年7月に OpenSearch 1.0 をリリースしました。そして2021年9月8日、マネージドサービスの名前を Amazon Elasticsearch Service から Amazon OpenSearch Service へ改めたと発表しています(https://aws.amazon.com/jp/blogs/aws/amazon-elasticsearch-service-is-now-amazon-opensearch-service-and-supports-opensearch-10/)。
この経緯から、重要な事実が1つ導かれます。Amazon OpenSearch Service が動かせる Elasticsearch は、最後のオープンソース版である 7.10 までです。AWS公式ドキュメントも、サポート対象を「OpenSearch およびレガシーの Elasticsearch OSS(最後のオープンソース版である 7.10 まで)」と明記しています(https://docs.aws.amazon.com/opensearch-service/latest/developerguide/what-is.html)。Elastic社の Elasticsearch は8系・9系と進んでいますが、それはこのサービスの上では動きません。
ライセンスの現在地——2024年にもう一度動いている
ここまでが多くの日本語記事に書かれている内容ですが、話はここで止まっていません。2024年8月29日、Elastic社は「Elasticsearch は再びオープンソースになった」と発表し、OSI承認ライセンスである AGPLv3 を選択肢として追加しました(https://www.elastic.co/blog/elasticsearch-is-open-source-again)。同社は、3年前にライセンスを変更した主な理由がAWSとの競合による市場の混乱への対処であり、状況が改善したため戻せると判断した、と説明しています。
ただし、既存のライセンスが取り下げられたわけではありません。Elastic社のライセンスFAQによれば、現在ソースコードは AGPLv3 / SSPL 1.0 / Elastic License 2.0 の3つから選べる状態で、既定の配布物は引き続き Elastic License 2.0 です(https://www.elastic.co/pricing/faq/licensing)。つまり「オープンソースに戻った」という見出しだけを読んで、配布されているバイナリがApache 2.0相当になったと誤解すると、法務確認でつまずきます。
OpenSearch 側にも動きがありました。2024年9月16日、Linux Foundation が OpenSearch Software Foundation の設立を発表し、それまでAWSがホストしていた OpenSearch プロジェクトはこの財団の下へ移りました(https://www.linuxfoundation.org/press/linux-foundation-announces-opensearch-software-foundation-to-foster-open-collaboration-in-search-and-analytics)。プレミアメンバーはAWS・SAP・Uberで、AWSは参加企業の1社という位置づけになっています。
改名で変わったもの・変わらなかったもの
AWSは改名で何が変わったかを一覧化しています(https://docs.aws.amazon.com/opensearch-service/latest/developerguide/rename.html)。既存環境を引き継いだ方が確認しておくとよい点は、次のとおりです。
項目 | 変わったか | 内容 |
|---|---|---|
サービス名 | 変わった | Amazon Elasticsearch Service → Amazon OpenSearch Service |
インスタンスタイプの表記 | 変わった |
|
管理画面(Kibana) | 変わった | OpenSearch Dashboards へ。 |
CloudWatchのメトリクス名 | 変わった | 例: |
設定API | 変わった | 例: |
サービスプリンシパル | 変わらない |
|
ドメインのARN・エンドポイント | 変わらない | そのまま |
特に見落としやすいのは CloudWatch メトリクスです。AWSは「OpenSearch へアップグレードするとメトリクスが自動的に変わり、現在のアラームは壊れる」と明記しており、アップグレード前にアラームを更新するよう求めています。逆にエンドポイントとARNは変わらないため、アプリケーション側の接続先はそのままで動きます。
なお OpenSearch には互換モードという設定があり、有効にするとクラスターがバージョンを 7.10 として報告します。接続前にバージョンを確認する古いクライアントやプラグインを動かし続けるための仕組みで、アップグレード時は既定で有効になります。
ここまでを3つの名前に整理すると、次のようになります。
名前 | 何か | ライセンス | AWSとの関係 |
|---|---|---|---|
Elasticsearch | Elastic社の検索・分析エンジン | ソースは AGPLv3 / SSPL 1.0 / Elastic License 2.0 の3択。既定配布物は Elastic License 2.0 | Amazon OpenSearch Service 上では 7.10 までのOSS版のみ動く |
OpenSearch | Elasticsearch 7.10.2 から分岐したオープンソースの検索・分析エンジン | Apache License 2.0 | 2024年9月から Linux Foundation の OpenSearch Software Foundation が運営。AWSはプレミアメンバーの1社 |
Amazon OpenSearch Service | 上記を動かすAWSのマネージドサービス(旧 Amazon Elasticsearch Service) | — | AWSが提供。クラスターの構築・監視・ノード交換を代行 |
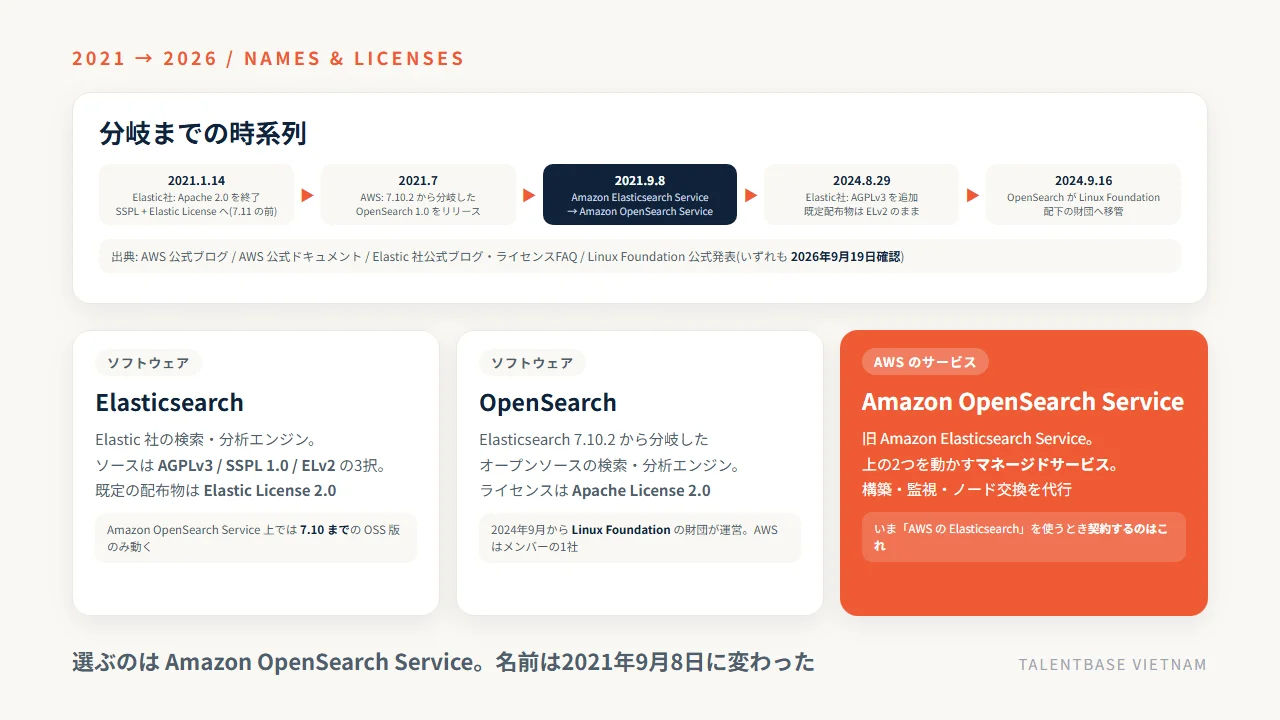
クラウドで基盤を借りるという仕組み自体の説明は、『クラウドとは』の記事に譲ります。ここで押さえておきたいのは、サービスの名前(Amazon OpenSearch Service)と、その上で動くソフトウェアの名前(OpenSearch / Elasticsearch)が別の階層にあるという一点です。見積書や設計書に「Elasticsearch」とだけ書かれている場合、どちらの階層の話なのかを確認する必要があります。
そもそも全文検索エンジンが要るのか——データベースのLIKE検索で足りなくなる境界
名前が確定したところで、次の問いに移ります。自社に全文検索エンジンが本当に必要なのか、という問いです。当社にも「検索が遅いのでElasticsearchを入れたい」という相談は届きますが、話を聞いていくと必要なのは検索エンジンではなくインデックスの追加やクエリの見直しだったというケースが一定数あります。順番を逆にすると、必要のない月額が固定費として残ります。まずは境界を見極めます。
LIKE検索の3つの限界——PostgreSQL公式が明記していること
多くのシステムは、最初はデータベースの部分一致検索(SQLの LIKE や正規表現)で検索機能を作ります。PostgreSQLの公式ドキュメントは、この方式の限界を3つ挙げています(https://www.postgresql.org/docs/current/textsearch-intro.html)。
限界 | 内容 | 現場での症状 |
|---|---|---|
言語的な処理がない | 活用形や派生語を同じ語として扱えない | 「申し込み」で探しても「申込」「申込み」が出ない |
順位付けがない | 一致した件数が多いと、関連度順に並べられない | 検索結果が500件出るが、上から見ても欲しいものが出てこない |
インデックスがなく遅い | 検索のたびに全件を走査する | データが増えるほど比例して遅くなる |
重要なのは、この3つは別々の問題だということです。「遅い」だけなら、データベース側のインデックス設計や検索条件の見直しで解決することがあります。全文検索エンジンが本当に効くのは、3つ目(遅い)だけでなく、1つ目(表記ゆれ)と2つ目(並べ替え)が同時に問題になっているときです。
インデックスという考え方——検索エンジンが速い理由は「先に作ってある」から
全文検索エンジンが速いのは、検索のたびに文章を読むのをやめて、「どの語がどの文書に出てくるか」の対応表を先に作っておくからです。本の巻末にある索引と同じ発想で、これを転置インデックスと呼びます。比喩はここまでにして、発注判断に効く性質を3つ挙げます。
- 書き込みのたびにインデックスを作り直す必要がある。 データの登録・更新のたびに検索エンジン側にも反映する仕組みが要ります。ここが開発工数として乗ります
- 反映までに間がある。 OpenSearchのインデックスは結果整合性で、更新が検索可能になるのはリフレッシュ後です。AWSの推奨はリフレッシュ間隔を30秒以上に設定することであり、「登録した直後に検索できる」ことを要件にすると性能設計が一段難しくなります(https://docs.aws.amazon.com/opensearch-service/latest/developerguide/bp.html)
- 元データは別に持つ。 検索エンジンは検索用のコピーであって、正本のデータベースを置き換えるものではありません。データベースは残ります
つまり全文検索エンジンを入れるということは、データベースの隣にもう1つデータの置き場が増えるということです。構築費だけでなく、同期の仕組みと、2か所のデータが食い違ったときの対処が運用に加わります。
入れなくてよい場合と、入れたほうがよい場合の境界
上の性質をふまえると、境界は次のように整理できます。
入れなくてよい可能性が高い場合
- 検索対象が数万件以下で、今後も桁が変わる見込みがない
- 検索条件が「コードの完全一致」「日付の範囲」「区分での絞り込み」が中心で、文章を探しているわけではない
- 検索結果を関連度順ではなく、日付順・金額順など明確な順序で並べれば用が足りる
- 遅さの原因がデータベースのインデックス設計や検索条件にある(まだ調べていないなら、先に調べる)
入れたほうがよい可能性が高い場合
- 数十万件以上の文章(商品説明、問い合わせ履歴、ドキュメント)から探す
- 表記ゆれや同義語を吸収する必要がある(「パソコン」と「PC」を同じ扱いにするなど)
- 関連度順に並べることが機能の価値そのものになっている(検索結果の上位3件で決まる)
- 検索条件が複雑で、絞り込みの組み合わせ(ファセット)や件数の集計を同時に返したい
判断の入口としては、「並べ替えが要るか」を最初に確認するのが実務的です。関連度順が要らないなら、検索エンジンの主要な価値の半分は使わないことになります。業務システムでの検索要件は、扱う対象によって難易度が変わります。顧客情報が対象なら『顧客管理システム開発』の記事、社内の在庫データが対象なら『在庫管理システムの自作』の記事、商品検索が対象なら『ECサイト開発の外注費用』の記事で、それぞれの文脈に沿った論点を扱っています。自社の対象に近いものを参照してください。
日本語の全文検索が難しい理由——単語の区切り、形態素解析、N-gram
ここは、日本語の検索機能の見積もりが英語圏の事例より高くなる理由を説明する章です。技術的な話になりますが、「どこで切るか」という1つの論点に集約できます。切り方の選択は後から変えるとインデックスの作り直しになるため、要件定義の段階で決めておく必要があります。
日本語には単語の区切りがない——MySQL公式が「制約」と書いていること
英語の文は空白で単語が区切られています。検索エンジンは文章を「トークン」という単位に切ってインデックスを作りますが、英語なら空白で切れば済みます。日本語にはその区切りがありません。
MySQLの公式リファレンスは、この点を明確に書いています。組み込みの全文検索パーサーは単語間の空白を区切りとして単語の開始と終了を判定するため、「単語の区切りを使わない表意文字の言語では制約になる」と明記し、中国語・日本語・韓国語(CJK)向けに ngram パーサーを別途用意しています(https://dev.mysql.com/doc/refman/8.4/en/fulltext-search-ngram.html)。つまり、日本語の全文検索は「標準機能をそのまま使えば動く」ものではなく、切り方を明示的に設定して初めて成立します。
形態素解析とN-gram——切り方が2通りあり、どちらも一長一短
日本語を切る方法は、大きく2つです。
形態素解析は、辞書を使って文法的に意味のある単位に切る方法です。OpenSearch では analysis-kuromoji プラグインが標準的に使われます。AWSのプラグイン一覧によれば、kuromoji と ICU Analysis は Amazon OpenSearch Service の全ドメインに同梱されており、追加インストールなしで使えます(https://docs.aws.amazon.com/opensearch-service/latest/developerguide/supported-plugins.html)。
kuromoji の切り方には3つのモードがあります(https://docs.opensearch.org/latest/analyzers/tokenizers/kuromoji/)。
モード | 複合語の扱い | 未知語の扱い |
|---|---|---|
normal | 1つのトークンとして保持(例: 関西国際空港はそのまま) | 1つのトークンとして保持 |
search(既定) | 複合語に加えて構成要素にも分割(関西 / 国際 / 空港 / 関西国際空港) | 1つのトークンとして保持 |
extended | normal と同じ | 1文字ずつに分割し、すべての文字をインデックスする |
N-gramは、意味を考えずに決まった文字数で機械的に切る方法です。MySQLの ngram パーサーは既定のトークンサイズが2(バイグラム)で、たとえば「abc def」は「ab」「bc」「de」「ef」の4トークンになります。日本語なら「東京都庁」は「東京」「京都」「都庁」に切られます。
2つの違いは、検索漏れとノイズのどちらを許容するかに現れます。
方式 | 強い点 | 弱い点 |
|---|---|---|
形態素解析(kuromoji) | 意味のある単位で切るためノイズが少ない。インデックスが小さい | 辞書にない語が切れない。「東京都庁」を「東京」「都庁」と切ると「京都」では引っかからない代わりに、辞書が古いと新語を取りこぼす |
N-gram(2文字) | 辞書に依存せず、未知語も必ず引ける | 「東京都」を検索すると「京都」を含む文書が混じるなど、意味の切れ目を無視したノイズが出る。インデックスが大きくなる |
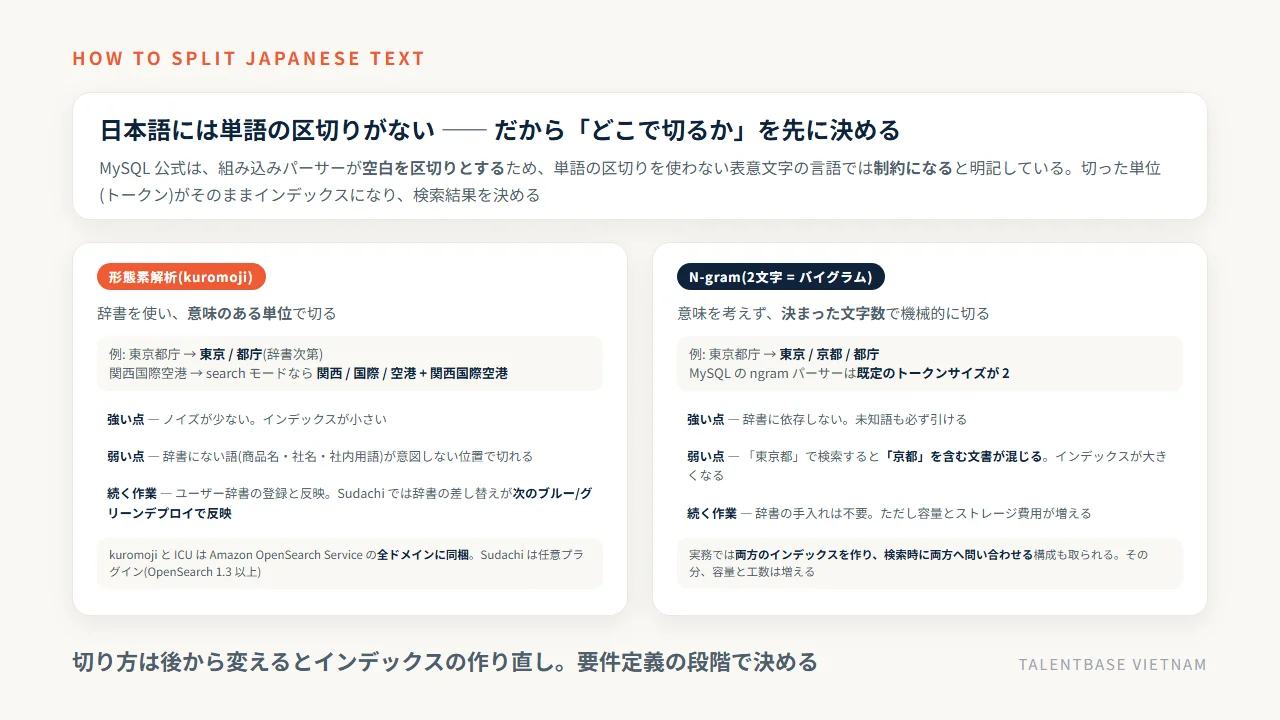
実務では、両方のインデックスを作り、検索時に両方へ問い合わせる構成が取られることが多い方式です。取りこぼしをN-gramで拾い、精度を形態素解析で担保する考え方ですが、その分インデックスの容量と構築工数は増えます。「日本語対応」という一行が見積書にあったら、この2方式のどちらか、あるいは両方かを確認してください。容量が変われば、次の章で見るストレージ費用も変わります。
辞書の手入れは運用として続く——商品名・人名・社内用語
形態素解析を選ぶと、辞書が検索品質を決めます。商品名、サービス名、人名、社内用語といった固有名詞は一般辞書に載っていないため、意図しない位置で切られます。「TALENTBASE VIETNAM」のような語が「TALENT」「BASE」と切られれば、社名での検索がうまく働きません。これを直すのがユーザー辞書の登録で、製品が増えるたび、用語が変わるたびに続く作業です。
AWSのドキュメントには、この運用上の注意も書かれています。日本語向けに推奨されている Sudachi プラグイン(OpenSearch 1.3以上で利用可能な任意プラグイン)では、辞書ファイルを再関連付けしてもドメインに即座には反映されず、次のブルー/グリーンデプロイのタイミングで更新されると明記されています。代替として、新しいパッケージで新しいインデックスを作り、既存インデックスから再インデックスして古い方を削除する手順が案内されています。
つまり辞書の更新は「ファイルを差し替えて終わり」ではなく、反映のための作業と、反映中も検索を止めない工夫(インデックスのエイリアス運用)がセットになるということです。この作業を誰が持ち続けるのかは、体制の話に直結します。後半で改めて触れます。
Amazon OpenSearch Service で決める4つ——構成、ストレージ、可用性ゾーン、アクセス制御
マネージドサービスを使っても、決めることはゼロになりません。AWSが代行するのはノードの調達・監視・故障時の交換であって、どういう構成にするかの判断は発注側に残ります。ここで挙げる4つは、いずれも後から変えると再構築に近い作業になり、そのまま月額に効きます。見積書を読むときの項目としても使えます。
デプロイ方式——自分でノードを決める方式と、決めない方式
Amazon OpenSearch Service には、ノードの種類と台数を自分で指定するマネージドクラスター(ドメイン)と、指定せずに利用量に応じて自動で増減するOpenSearch Serverless があります。
マネージドクラスターは、台数が決まっているぶん月額が読めます。逆に、使っていない時間も課金されます。Serverless は構成を決めなくてよい代わりに、課金単位が OCU(OpenSearch Compute Unit)という計算資源の時間になり、負荷に応じて金額が動きます。
どちらを選ぶかは「月額を固定したいか、構成の検討を省きたいか」で決まります。検索の負荷が安定していて予算を固定したい業務システムはマネージドクラスター、負荷の予測がつかない初期のサービスは Serverless、という分け方が実務的です。
インスタンス構成とシャード——AWS公式が示している目安の数値
マネージドクラスターを選ぶと、ノードの種類・台数と、インデックスをいくつに分割するか(シャード数)を決めます。AWSの運用ベストプラクティスには、判断に使える数値が明記されています(https://docs.aws.amazon.com/opensearch-service/latest/developerguide/bp.html)。
項目 | AWSが示す目安 |
|---|---|
シャード1つのサイズ | 検索用途で10〜30GiB、ログ用途で30〜50GiB。50GiBを上限とする |
シャード数 | データノード数の倍数にする(12シャードならノードは2・3・4・6・12のいずれか) |
1ノードが持つシャード数 | JVMヒープ1GiBあたり25シャード以下(ヒープ32GiBなら800シャード以下) |
シャードとvCPUの比 | 初期値としてシャード1つに1.5 vCPU |
本番で避けるインスタンス | T2および |
リフレッシュ間隔 | すべてのインデックスで30秒以上 |
一括登録(bulk)のサイズ | 3〜5MiBから始める |
数値の意味は1つずつ追わなくて構いません。発注側として確認すべきは、「これらの目安に照らしてこの台数になった」という説明が見積もりに付いているかどうかです。説明なしに台数だけ提示されている場合、根拠を尋ねる価値があります。台数が費用に直結する構造は、Web/AP/DBの3層構成でも同じです。この点は『APサーバーとは』の記事で扱っています。
ストレージは、データノードに付けるEBSボリュームで決めます。AWSは最新世代の gp3 を推奨しており、旧世代の gp2 より基準性能が高く 9.6% 安いこと、容量と独立して IOPS とスループットを追加できることを挙げています。また、ログのように書き込んだ後は読むだけになるデータについては、S3を使う UltraWarm とコールドストレージへ移す方法があり、移行のメリットが出始めるのは、ホットストレージから移すデータがおおよそ 2.5TiB に達したあたりとされています。
可用性ゾーンと専用マスターノード——止まらないための構成は台数で決まる
冗長化の方針も、ここで決めます。AWSの推奨は明確です。
- 3つのアベイラビリティゾーンにノードを分散する(2ゾーン構成だと1ゾーンの障害で容量の半分を失う)
- 専用マスターノードを3台置く(クラスター管理だけを担当し、データを持たないノード。構成変更を無停止で行えるようになる)
- 推奨構成は Multi-AZ with Standby。3ゾーンのうち2つを稼働、1つを待機とし、インデックスごとにレプリカシャードを2つ持つ。専用マスターノード3台もこの設定で自動的に構成される
- レプリカは最低1つは必ず持つ
費用の観点では、ここが台数の増える最大の要因です。データノード3台の構成に専用マスターノード3台を足せば、稼働するインスタンスは6台になります。なお、AWSは同一ドメイン内のアベイラビリティゾーン間の通信にデータ転送料金を課金しないと明記しているため、ゾーンを増やすこと自体で転送料が増えるわけではありません。増えるのはインスタンス時間です。
冗長化しても障害はゼロにはなりません。障害が起きたときの動き方や保守契約で決める項目は『サーバー障害の原因と対応』の記事に譲ります。ここでは「可用性の水準は構成(=台数)で決まり、要件として先に決めるもの」という点だけ押さえてください。可用性や性能を要件としてどう書くかは『非機能要件とは』の記事が参考になります。
アクセス制御——VPC、アクセスポリシー、きめ細かなアクセスコントロール、暗号化
検索基盤には、業務データの実体が入ります。AWSがセキュリティのベストプラクティスとして挙げているのは次の5点です。
項目 | AWSの推奨 |
|---|---|
VPC内への配置 | インターネットゲートウェイを介さず通信する。パブリックエンドポイントより1段安全 |
アクセスポリシー | 制限的なリソースベースポリシーを適用し、最小権限に従う。 |
きめ細かなアクセスコントロール | クラスター・インデックス・ドキュメント・フィールドの単位で権限を分ける。有効化を推奨 |
保管時の暗号化 | AWS KMS と AES-256 による暗号化。機微なデータを扱うなら有効化 |
ノード間の暗号化 | ノード間通信をTLSで保護。機微なデータを扱うなら有効化 |
実務でよく問題になるのは2つ目です。認証の都合でアクセスポリシーを開けたまま運用してしまうケースがあります。AWSは、きめ細かなアクセスコントロールを有効にしている場合など一部の状況では開いたポリシーも許容されるとしていますが、それは「別の層で守られている場合に限る」という条件付きです。アプリケーションからどう呼ぶかの設計は『APIとは』の記事、サービスを分割している場合の考え方は『マイクロサービスとは』の記事で扱っています。
見積書を確認するときのチェックリストとして、次の6点を推奨します。
- デプロイ方式(マネージドクラスターか Serverless か)とその理由
- データノードの種類・台数と、シャード数の根拠
- 専用マスターノードの有無と台数
- アベイラビリティゾーン数(2か3か)
- ストレージの種類(gp3か)と容量、UltraWarm/コールドストレージの使用有無
- VPC配置・アクセスポリシー・きめ細かなアクセスコントロール・暗号化の設定方針
料金はどこで膨らむか——東京リージョンの公開単価と、増える3つの方向
ここが、相談で最も多く聞かれる部分です。Amazon OpenSearch Service の課金は、マネージドクラスターならインスタンス時間+ストレージ、Serverless ならOCU時間+ストレージが柱になります。以下の数値は、AWSが公開している価格データ(AWS Price List API・アジアパシフィック(東京)リージョン・公開日2026年9月11日)から直接引いたもので、いずれもオンデマンドの1時間あたり単価です。2026年9月19日に確認しています。
東京リージョンの公開単価——AWS公式の価格データから
項目 | 東京リージョンの単価(USD) | 月730時間換算(USD) | 円換算の目安 |
|---|---|---|---|
t3.small.search | 0.056 / 時 | 40.88 | 約6,100円 |
t3.medium.search | 0.112 / 時 | 81.76 | 約12,300円 |
c6g.large.search | 0.142 / 時 | 103.66 | 約15,500円 |
m6g.large.search | 0.164 / 時 | 119.72 | 約18,000円 |
r6g.large.search | 0.202 / 時 | 147.46 | 約22,100円 |
r6g.xlarge.search | 0.404 / 時 | 294.92 | 約44,200円 |
ultrawarm1.medium.search | 0.279 / 時 | 203.67 | 約30,600円 |
EBS gp3 ストレージ | 0.1464 / GB・月 | — | 約22円/GB・月 |
EBS gp2 ストレージ | 0.162 / GB・月 | — | 約24円/GB・月 |
マネージドストレージ(UltraWarm・コールド) | 0.026 / GB・月 | — | 約4円/GB・月 |
Serverless(検索OCU / 取り込みOCU) | 0.334 / OCU・時 | — | — |
Serverless のストレージ | 0.36 / GB・月 | — | 約54円/GB・月 |
※1USD=150円換算目安。円換算は概算で、実際の請求は為替により変動します。
この表から2つの試算ができます。
開発・検証用の最小構成: t3.small.search 1台にgp3を10GB付けると、月40.88+1.46=約42.3USD(約6,400円)。ただしAWSは本番では T2 と t3.small を避けるよう明記しているため、これはあくまで検証用です。
本番想定の構成: 前の章で見たAWS推奨に沿って、データノード r6g.large.search 3台+専用マスターノード3台の計6台にすると、インスタンスだけで 147.46×6=884.76USD(約13万3,000円)。これにgp3を1台200GBずつ計600GB付けると 87.84USD(約1万3,200円)が加わり、合計およそ972USD(約14万6,000円)が月額の下限になります。データ転送、ログ出力、スナップショット以外のバックアップは別途です。
この金額が毎月、使っていない時間も含めて発生します。検索が1日100回しか使われなくても、クラスターは24時間動いています。ここが、機能の利用頻度と費用が比例しない検索基盤の特徴です。
膨らむ3つの方向——台数、保持期間、放置
見積もり時点より請求が膨らむ経路は、経験上ほぼ3つに集約されます。
1つ目は台数です。シャードのサイズ上限(AWS推奨で50GiB)に達すればシャードを増やし、シャードを増やせばノードも増えます。データが増え続ける設計なら、費用も増え続けます。逆に言えば、「何年分のデータを検索対象にするか」を決めていない見積もりは、必ず後でずれます。
2つ目は保持期間です。ログのように増え続けるデータをホットストレージに置き続けると、gp3の22円/GB・月が効いてきます。UltraWarm・コールドストレージへ移せば約4円/GB・月になりますが、UltraWarm自体のノード(ultrawarm1.medium.search で月約3万円)が必要です。AWSは移行のメリットが出るのはおおよそ2.5TiBからとしているため、それ未満の規模で階層を分けると、かえって高くつきます。
3つ目は放置です。これが一番見落とされます。AWSはバージョンごとに標準サポートと延長サポートの期限を定めており、標準サポートが終わったバージョンを動かし続けると延長サポート料金が自動的に加算されます(https://docs.aws.amazon.com/opensearch-service/latest/developerguide/what-is.html)。東京リージョンの延長サポート料金は、価格データ上 1正規化インスタンス時間(NIH)あたり0.0081USDです。さらにAWSは、当初の延長サポート期限をさらに延長したバージョンについては、延長サポート料がインスタンス料金と同額になる(実質的に単価が2倍になる)と明記しています。
具体的な期限も公開されています。Elasticsearch 7.10 と OpenSearch 1.3 は標準サポートが2027年11月7日まで、延長サポートが2030年11月7日まで。Elasticsearch 7.1〜7.8 や OpenSearch 1.0〜1.2 はすでに標準サポートが終了し、延長サポートも2027年11月7日までです。古い環境を引き継いだ場合、まず確認すべきはこの期限です。
なお、構成が安定したあとはリザーブドインスタンスで下げられます。AWSは割引の目安を、前払いなし1年で約30%から、全額前払い3年で最大50%としており、14日以上安定稼働してから推奨を確認するよう案内しています。システム開発全体のコストの下げ方は『システム開発コスト削減』の記事、見積書の読み方は『システム開発の見積もりの内訳』の記事で扱っています。
代替の選択肢1: データベースの全文検索機能で足りないか
前述のとおり、MySQLは ngram パーサーを備えており、CJK向けの全文検索インデックスを作れます。PostgreSQLも全文検索機能を持ちます(日本語の形態素解析には別途拡張が必要です)。すでに使っているデータベースの中で完結するなら、追加のインスタンス費用も同期の仕組みも要りません。
適しているのは、検索対象が単一のテーブル群に収まり、件数が数十万件程度までで、関連度順の精度に強い要求がない場合です。逆に、複数のデータソースをまたぐ、日本語の精度を詰める、ファセット集計を返す、といった要件が入ると、データベース側では厳しくなります。
代替の選択肢2: 検索SaaS(Algolia等)に外に出す
検索機能そのものをSaaSとして借りる選択肢もあります。たとえば Algolia の公開プランでは、無料枠が月10,000件の検索リクエストと50,000レコード、Grow プランは月10,000件の検索リクエストを含み超過分が1,000件あたり0.50USD、レコードは100,000件を含み超過分が1,000件あたり0.40USDです(https://www.algolia.com/pricing・2026年9月19日確認)。
この方式の利点は、サーバーの構成を一切決めなくてよいことと、使った量で課金されることです。検索回数が少ないうちは圧倒的に安くなります。一方、検索対象のデータを外部サービスに渡すため、扱うデータの性質によっては採用できません。また、レコード数が増えるほど費用が伸びるため、大量の文書を対象にする用途では逆転します。
3つの選択肢を1つの表にすると、判断の軸がはっきりします。
選択肢 | 向く規模 | 費用の出方 | 主な制約 |
|---|---|---|---|
データベースの全文検索機能 | 数十万件まで | 追加費用なし(既存DBの範囲) | 日本語の精度とファセットに限界 |
Amazon OpenSearch Service | 数十万件〜 | 固定費(インスタンス時間+ストレージ) | 構成の判断と運用が発注側に残る |
検索SaaS(Algolia等) | 検索回数が少なく、レコード数が読める範囲 | 従量課金 | データを外部に預ける。件数が増えると割高になりうる |
「まずデータベースの機能で試し、足りないと分かってから検索エンジンを入れる」という順番は、遠回りに見えて結果的に安く済むことが多いのが実情です。入れない判断も、十分にまっとうな判断です。
検索基盤を含むシステムを外部チームで作る・運用するときの体制——当社の位置づけ
最後に、体制の話をします。ここまで見てきたとおり、検索基盤は構築して引き渡せば終わる部品ではありません。作る人と持ち続ける人が分かれている体制だと、続く作業が誰の仕事でもなくなります。発注前にここを決めておくかどうかで、1年後の状態がかなり変わります。
検索基盤は「作って終わり」にならない——続く作業は4種類
リリース後に発生し続ける作業は、おおむね次の4つです。
続く作業 | 内容 | 頻度の目安 |
|---|---|---|
辞書の手入れ | 商品名・人名・社内用語をユーザー辞書に登録し、反映させる | 新しい用語が出るたび |
バージョンアップ | 標準サポートの期限に合わせてエンジンを上げる。サービスソフトウェアの更新も別にある | 期限に合わせて計画的に |
構成の見直し | データ量の増加に応じてシャード数・ノード数・ストレージ階層を再設計する | データ量が桁で変わったとき |
費用の見直し | 稼働が安定したらリザーブドインスタンスを検討する。不要なインデックスを消す | 半年〜1年ごと |
このうち、放置の影響が最も大きいのはバージョンアップです。前の章で見たとおり、標準サポートが切れたバージョンを動かし続けると延長サポート料金が自動で加算され、バージョンによってはインスタンス料金が実質2倍になります。「動いているから触らない」がそのまま費用になる構造です。保守・改修を外に出す場合の考え方は『システム改修・開発保守の外注』の記事で扱っています。
外部チームに任せるとき、発注側が確認する4点
上の4種類を前提にすると、発注時に確認すべき点は絞られます。
- 構成の根拠が文書化されるか。ノード台数・シャード数・アベイラビリティゾーン数・ストレージ階層を、なぜその値にしたかとあわせて残してもらう。これがないと、次にデータが増えたとき誰も判断できません
- 日本語の切り方(形態素解析かN-gramか、両方か)と辞書の運用手順が決まっているか。辞書の更新を誰がどう行い、いつ反映されるかまで含めて決めます
- バージョンアップの計画が契約に入っているか。サポート期限は公開されているため、あらかじめ計画に織り込めます
- アクセス制御の設定方針が明示されているか。VPC配置、アクセスポリシー、きめ細かなアクセスコントロール、暗号化の4点です
オフショアを含む外部チームに任せる場合、品質の担保が「人」に依存していないかという観点が加わります。この点は『オフショア開発の品質』の記事で詳しく扱っています。
当社の担い方——AWS認定11冠の体制と、日本人PMをフロントに置いたラボ型
当社(TALENTBASE VIETNAM)は、ベトナム・ホーチミンを拠点に、日本企業の開発チームを外部で組成する事業を行っています。これまで約100社の開発体制づくりを支援してきました。AWS上のシステム開発については、AWS認定11冠の体制を持ち、AI活用を前提とした開発体制を取っています。
体制は2パターンあります。日本人PM/ブリッジSEをフロントに置いてエンジニアを組み合わせるパターンA(推奨)と、エンジニアのみのパターンBです。続く作業が4種類ある検索基盤のような領域では、パターンAを推奨しています。辞書の手入れやバージョンアップの判断は、日本語の業務要件と技術の両方が分かる人が間に立たないと止まりやすいためです。品質面では、日本人PMによる設計レビュー、Gitのプルリクエストによるコードレビューの標準化、リリース前のダブルチェックの3点を標準の工程として回しています。
契約面では、1名から、最短2週間で開始でき、増員は約1週間、縮小や交代(リプレイスメント)は1か月単位で対応します。公開している単価は実務3年目安で月1,500USD(約22.5万円)、5年で2,000USD、10年目安およびブリッジSEで3,000USDです(1USD=150円換算目安)。契約と支払いは日本国内法人・日本法準拠で、海外送金は不要です。
正直に書いておくと、当社は検索基盤そのものを専門にしている会社ではありません。Amazon OpenSearch Service の大規模なチューニングや、検索精度の研究が中心になる案件は、その領域の専門チームを探したほうが結果は良くなります。当社が向くのは、業務システムやSaaSの開発・運用を継続して持ち、その一部として検索機能も面倒を見続ける形です。CareViewer(介護記録SaaS)では日本語対応のブリッジSE1名とフルスタックエンジニア2名の体制で継続開発を担い、週次で優先順位を判断しながら進めています。こうした「持ち続ける体制」が必要な案件であれば、力になれる可能性が高いと考えています。
【FAQ】AWSのElasticsearch(Amazon OpenSearch Service)に関するよくある質問
最後に、相談の場で実際によく出る質問を5つ挙げます。いずれも公式情報で確認できる範囲で答えます。記事の内容を短く確認したい方は、ここだけ読んでも要点はつかめます。
Q1. 結局、いまAWSで全文検索エンジンを使うと何を選ぶことになりますか
サービスは Amazon OpenSearch Service です。その上で動かすエンジンとして OpenSearch(最新は3系)か、レガシーの Elasticsearch OSS(7.10まで)を選びます。新規であれば OpenSearch の新しいバージョンを選ぶのが基本です。AWSも、価格性能・機能・セキュリティの観点から最新版への更新を推奨しています。
Q2. 既存のElasticsearch 7.10はいつまで使えますか
AWSの公開スケジュールでは、Elasticsearch 7.10 の標準サポートは2027年11月7日まで、延長サポートは2030年11月7日までです。標準サポートが終わった後も動き続けますが、延長サポート料金が自動的に加算されます。Elasticsearch 7.1〜7.8 はすでに標準サポートが終了しているため、該当する場合は移行計画を先に立ててください。
Q3. Elastic社のElasticsearch(8系・9系)をAWSで使えますか
Amazon OpenSearch Service の上では動きません。このサービスが対応するのは、最後のオープンソース版である Elasticsearch 7.10 までです。Elastic社の新しいバージョンを使いたい場合は、Elastic社が提供するサービスを利用するか、EC2などに自分で構築することになります。ライセンスは AGPLv3 / SSPL 1.0 / Elastic License 2.0 の3択で、既定の配布物は Elastic License 2.0 です。法務確認が必要な場合は、どのライセンスで入手するかを先に決めてください。
Q4. 日本語検索で、最初に決めることは何ですか
切り方です。形態素解析(kuromoji)にするか、N-gramにするか、両方のインデックスを作るかを決めます。後から変えるとインデックスの作り直しになるため、要件定義の段階で決めます。あわせて、ユーザー辞書を誰がどう更新し、いつ反映されるかも決めておいてください。kuromoji と ICU Analysis は Amazon OpenSearch Service の全ドメインに同梱されています。
Q5. 小さく試すといくらかかりますか
検証用途なら、東京リージョンの t3.small.search 1台(1時間0.056USD)にgp3を10GB付けて月42USD前後、日本円で約6,400円が目安です。ただしAWSは本番での T2 / t3.small の使用を避けるよう明記しているため、本番を見据えるならデータノード3台+専用マスターノード3台の構成で月14万円台からの試算。
まとめ: 「AWSのElasticsearch」は Amazon OpenSearch Service——名前を確定させたら、次は要るかどうかと、払い続けられるかどうか
検索されている「aws elasticsearch」という名前は、2021年9月8日を最後に公式には使われていません。いまAWSで全文検索エンジンをマネージドで使うなら、契約するのは Amazon OpenSearch Service であり、その上で動かすのは OpenSearch か、7.10で止まったレガシーの Elasticsearch OSS のどちらかです。名前が分かれた原因はライセンスで、2021年1月にElastic社がApache 2.0をやめ、2024年8月にAGPLv3を追加し、OpenSearchは2024年9月にLinux Foundationへ移りました。古い記事のとおりに設計すると、バージョンとサポート期限の前提まで古いまま進むことになります。
名前が確定したら、次は「本当に要るのか」です。LIKE検索の限界は、言語的な処理がないこと・順位付けができないこと・インデックスがなく遅いことの3つで、この3つが同時に効き始めていないなら、データベース側の見直しで足りる可能性があります。入れると決めたら、日本語の切り方(形態素解析かN-gramか)、ノード構成とシャード、アベイラビリティゾーン、アクセス制御の4つを要件定義の段階で決めてください。いずれも後から変えると作り直しに近い作業になります。
費用は、東京リージョンのデータノード3台+専用マスターノード3台の構成で月14万円台からが目安です。使っていない時間も課金され、標準サポートが切れたバージョンを放置すれば延長サポート料金が加算されます。検索基盤は作って終わりではなく、辞書の手入れ・バージョンアップ・構成の見直し・費用の見直しが続きます。だからこそ、作る人と持ち続ける人を分けない体制にしておくことが、1年後の状態を決めます。継続して開発と運用を持つ体制の作り方はラボ型開発とはを、保守・改修を外に出す場合の考え方はシステム改修・開発保守の外注をあわせてご覧ください。
現在の体制と要件をお聞かせいただければ、どの選択肢が合うか、どのくらいの体制になるかを概算見積もりでお答えします。合わない案件にはその旨も率直にお伝えします。